· Tutoriel
Ball Thrust 3D : de Rapier au DQN entraînable
Un vrai monde physique, 21 observations, un DQN qui apprend et une inférence vérifiable après sauvegarde locale.
Relâchez la flèche droite : la sphère continue de rouler. Poussez vers un obstacle : elle se bloque ou rebondit. Dans Ball Thrust, ces réactions viennent du monde physique Rapier, pas d’une animation choisie par le réseau.
La démo relie maintenant le jeu manuel, un vrai environnement TrainingEnv, un DQN TensorFlow.js entraînable et l’inférence sur ce même réseau. On peut interrompre l’entraînement, conserver les poids dans le navigateur, recharger la page et observer la politique sans nouvelle mise à jour. Cela prouve un apprentissage effectif, pas une convergence automatique.
Jouer, entraîner et tester Ball Thrust 3D →
Le réseau commande une vraie physique
Une sphère cyan de 1 kg évolue dans une arène de 12 × 12 m, avec quatre murs et trois obstacles fixes. Tous ont de vrais colliders. Seule la sphère est dynamique ; ses mouvements proviennent d’impulsions, de la gravité et des contacts.
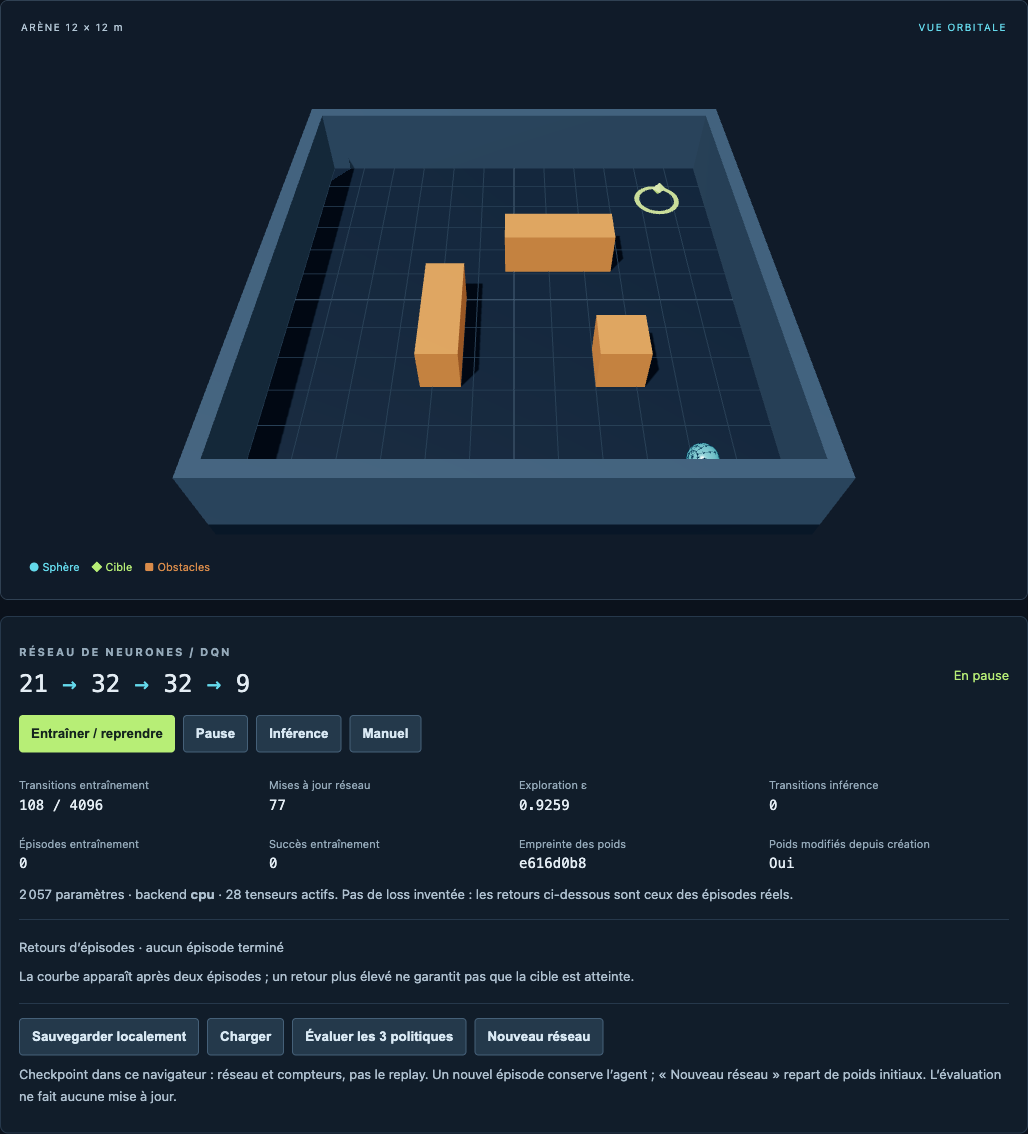
Capture réelle d’un essai court de développement : 108 transitions, 77 mises à jour et des poids modifiés. Ce n’est ni le protocole de 4096 transitions ni une preuve de navigation réussie.
Le monde avance à pas fixes de 1/60 s. Une décision applique une impulsion normalisée de 0,65 N·s puis six pas Rapier : une action représente donc 0,1 s simulée. Le frottement vaut 0,65, la restitution 0,55 ; CCD et contacts prédictifs limitent les traversées à grande vitesse. Aucun clamp de position ni contrôleur caché n’aide l’agent.
BallThrustEnv possède l’unique horloge physique. Le renderer R3F recopie la position et le quaternion Rapier, sans faire avancer une seconde simulation. L’entraînement accéléré change le temps mural, jamais le pas du solveur. Le HUD lit le même corps : position, vitesse, distance et temps simulé.
Commencer par jouer
La démo s’ouvre en mode manuel. Cliquez dans l’arène ou sélectionnez-la avec Tab :
| Commande | Effet |
|---|---|
| Flèches, WASD ou ZQSD | Impulsions horizontales |
| Deux directions combinées | Diagonale, sans bonus de puissance |
| Espace, même si une direction reste enfoncée | No-op : aucune nouvelle impulsion |
| Relâcher les touches | No-op également, pas un frein |
| Direction opposée au mouvement | Contre-poussée pour freiner |
| Glisser / molette | Orbiter / zoomer sans changer les axes des commandes |
Haut signifie −z et droite +x, quelle que soit la caméra. La perte de focus libère les touches ; le clavier n’intervient pas pendant l’entraînement ou l’inférence. Une mise en page étroite n’est pas un contrôleur tactile.
La graine uint32, par défaut 70, détermine le départ et la cible. Réinitialiser recrée le monde, stabilise la sphère pendant 120 pas hors compteur, puis laisse l’épisode en pause sans changer le réseau. Choisissez ensuite Manuel, Entraîner / reprendre ou Inférence. Même graine, moteur et séquence d’actions donnent la même trajectoire dans les tests ; ce n’est pas une garantie entre versions de Rapier.
Un contrat RL explicite
L’environnement accepte neuf indices : 0 no-op, 1 N, 2 NE, 3 E, 4 SE, 5 S, 6 SW, 7 W, 8 NW. Les tableaux et indices invalides sont refusés.
Les 21 observations, toutes finies et bornées dans [-1,1], contiennent :
- la position x/z divisée par 6 et la vitesse x/z divisée par 10 ;
- le delta vers la cible x/z divisé par 12 ;
- la hauteur au-dessus du rayon divisée par 2, puis la vitesse verticale divisée par 10 ;
- les trois vitesses angulaires divisées par 25 ;
- huit rayons horizontaux N, NE, E, SE, S, SW, W, NW, de portée 4 m, normalisés dans
[0,1]en excluant la sphère ; - la position x/z de la cible divisée par 6.
L’écrêtage normalise seulement les observations, pas le monde physique. La récompense dense est 5 × (distance précédente − distance actuelle) − 0,01, moins 0,001 pour une poussée, plus 15 pour la cible ou moins 15 en cas de sortie physique anormale.
La cible doit être à moins de 0,7 m près du sol. Succès ou défaillance physique donnent terminated. La limite de 300 actions, soit 30 s simulées, donne truncated, jamais les deux. L’épisode manuel se termine ; le runner remet automatiquement le monde à zéro en entraînement et en inférence.
Le code d’environnement réellement exécuté
Ce bloc est injecté depuis packages/demo-ball-thrust/src/ball-thrust-env.ts. Le même contrat est utilisé par la scène, le runner et les tests WASM. populateWorld() réutilise la factory physique du premier lot ; aucune physique simplifiée n’est réservée au réseau.
import RAPIER from '@dimforge/rapier3d-compat';
import type { TrainingEnv } from '@ignitionai/core';
import { BALL_RADIUS, GRAVITY, THRUST_INTERVAL, initialState, populateWorld, readState, thrust } from './physics';

/** Direction order shared by discrete actions and the eight horizontal sensors. */
export const ACTION_DIRECTIONS = [
  [0, 0], [0, -1], [1, -1], [1, 0], [1, 1],
  [0, 1], [-1, 1], [-1, 0], [-1, -1],
] as const;
export const ACTION_NAMES = ['no-op', 'N', 'NE', 'E', 'SE', 'S', 'SW', 'W', 'NW'] as const;
export type EpisodeOutcome = 'running' | 'success' | 'failure' | 'timeout';
export interface EpisodeSummary {
  return: number;
  steps: number;
  outcome: EpisodeOutcome;
  seed: number;
  distance: number;
}

/** Owns the simulation; Rapier.init() must be awaited by the caller first. */
export class BallThrustEnv implements TrainingEnv {
  readonly actions = ACTION_NAMES.length;
  world!: RAPIER.World;
  ball!: RAPIER.RigidBody;
  goal!: { x: number; y: number; z: number };
  seed: number;
  steps = 0;
  episodeReturn = 0;
  lastAction = 0;
  lastReward = 0;
  lastEpisode: EpisodeSummary | null = null;
  outcome: EpisodeOutcome = 'running';
  private disposed = false;

  constructor(seed = 70) {
    this.seed = seed;
    this.reset(seed);
  }

  get telemetry() { return readState(this.ball, this.goal, this.steps * THRUST_INTERVAL); }

  reset(seed = this.seed): void {
    initialState(seed); // Validate before freeing the existing world.
    if (this.world && !this.disposed) {
      if (this.steps > 0 && !this.done()) this.lastEpisode = this.summary();
      this.world.free();
    }
    this.world = new RAPIER.World(GRAVITY);
    this.disposed = false;
    const { ball, goal } = populateWorld(this.world, RAPIER, seed);
    this.ball = ball;
    this.goal = goal;
    for (let tick = 0; tick < 120; tick++) this.world.step();
    this.seed = seed;
    this.steps = 0;
    this.episodeReturn = 0;
    this.lastAction = 0;
    this.lastReward = 0;
    this.outcome = 'running';
  }

  step(action: number | number[]): void {
    if (typeof action !== 'number' || !Number.isInteger(action) || action < 0 || action >= this.actions) {
      throw new RangeError('Action must be an integer from 0 to 8 (arrays are not supported).');
    }
    if (this.disposed) throw new Error('BallThrustEnv is disposed; reset before stepping.');
    if (this.done()) return;
    const oldDistance = this.telemetry.distance;
    this.lastAction = action;
    // Do not feed an already non-finite body to the WASM solver.
    if (!this.failed()) {
      thrust(this.ball, ACTION_DIRECTIONS[action], 0);
      for (let tick = 0; tick < THRUST_INTERVAL; tick++) this.world.step();
    }
    this.steps++;
    if (this.failed()) this.outcome = 'failure';
    else if (this.telemetry.reached) this.outcome = 'success';
    else if (this.steps >= 300) this.outcome = 'timeout';
    const progress = oldDistance - this.telemetry.distance;
    this.lastReward = 5 * (Number.isFinite(progress) ? progress : 0) - 0.01 - (action === 0 ? 0 : 0.001)
      + (this.outcome === 'success' ? 15 : this.outcome === 'failure' ? -15 : 0);
    this.episodeReturn += this.lastReward;
    if (this.done()) this.lastEpisode = this.summary();
  }

  /**
   * 0..1 x,z/6; 2..3 vx,vz/10; 4..5 goal delta x,z/12;
   * 6 height above radius/2; 7 vy/10; 8..10 angular xyz/25;
   * 11..18 N,NE,E,SE,S,SW,W,NW solid rays/4; 19..20 goal x,z/6.
   * All values finite and clipped to [-1,1]; rays clipped to [0,1].
   */
  observe(): number[] {
    const { position: p, velocity: v } = this.telemetry;
    const angular = this.ball.angvel();
    const rays = ACTION_DIRECTIONS.slice(1).map(([x, z]) => {
      if (![p.x, p.y, p.z].every(Number.isFinite)) return 1;
      const length = Math.hypot(x, z);
      const ray = new RAPIER.Ray(p, { x: x / length, y: 0, z: z / length });
      const hit = this.world.castRay(ray, 4, true, undefined, undefined, undefined, this.ball);
      return Math.max(0, Math.min(1, (hit?.timeOfImpact ?? 4) / 4));
    });
    return [
      p.x / 6, p.z / 6, v.x / 10, v.z / 10,
      (this.goal.x - p.x) / 12, (this.goal.z - p.z) / 12,
      (p.y - BALL_RADIUS) / 2, v.y / 10, angular.x / 25, angular.y / 25, angular.z / 25,
      ...rays, this.goal.x / 6, this.goal.z / 6,
    ].map((value) => Number.isFinite(value) ? Math.max(-1, Math.min(1, value)) : 0);
  }

  reward(): number { return this.lastReward; }
  done(): boolean { return this.outcome !== 'running'; }
  terminated(): boolean { return this.outcome === 'success' || this.outcome === 'failure'; }
  truncated(): boolean { return this.outcome === 'timeout'; }

  dispose(): void {
    if (!this.disposed) this.world.free();
    this.disposed = true;
  }

  private failed(): boolean {
    const p = this.ball.translation();
    const v = this.ball.linvel();
    const a = this.ball.angvel();
    const q = this.ball.rotation();
    return ![p.x, p.y, p.z, v.x, v.y, v.z, a.x, a.y, a.z, q.x, q.y, q.z, q.w].every(Number.isFinite)
      || Math.abs(p.x) > 6.1 || Math.abs(p.z) > 6.1 || p.y < -1 || p.y > 3;
  }

  private summary(): EpisodeSummary {
    return { return: this.episodeReturn, steps: this.steps, outcome: this.outcome,
      seed: this.seed, distance: this.telemetry.distance };
  }
}
Entraîner, mettre en pause et faire de l’inférence
Le DQN existant possède 2057 paramètres, avec l’architecture 21 → 32 → 32 → 9. Il utilise TF.js sur CPU, Adam à 0,001, des batches de 32, un replay de 8192 transitions, γ = 0,99 et une cible mise à jour tous les 100 updates. La graine du réseau est 68. L’exploration part de 1 et décroît vers 0,05.
IgnitionEnvTFJS.step() fournit les transitions d’entraînement ; inferStep() choisit les actions greedy sans mémorisation ni fit. Le code de la démo ne réimplémente ni le replay ni les cibles de Bellman.
Dans le navigateur, Entraîner / reprendre fait évoluer le réseau. Pause attend aussi le fit déjà engagé avant de rendre la main. Inférence reprend exactement ce réseau, sans changer ses poids. Le panneau expose les compteurs d’updates, epsilon et une empreinte des poids ; la courbe montre les retours d’épisodes, pas une loss inventée.
Pour reproduire ces opérations dans le package :
import RAPIER from '@dimforge/rapier3d-compat';
import * as tf from '@tensorflow/tfjs';
import { BallThrustEnv } from './src/ball-thrust-env';
import { TrainingSession } from './src/training-session';

await RAPIER.init();
await tf.setBackend('cpu');
await tf.ready();
const session = new TrainingSession(new BallThrustEnv(70));
await session.runSteps(4096, 'training');
await session.save();
const evaluation = await session.evaluate();
await session.start('inference');
// À la fermeture : await session.dispose();
Sauvegarder localement écrit le modèle dans IndexedDB, avec version, configuration, epsilon et compteurs. Charger permet de retrouver les poids après rechargement de la page. Les métadonnées et les vrais tenseurs sont validés avant remplacement de l’agent actif. Une erreur de quota, un checkpoint absent ou incompatible reste visible.
Ce n’est pas une reprise bit à bit du processus d’entraînement : replay, état de l’optimiseur et position du générateur aléatoire ne sont pas restaurés. Le replay doit se remplir à nouveau. Nouveau réseau est l’action explicite qui repart des poids initiaux.
Mesurer plutôt que promettre une convergence
Le protocole versionné a été figé avant exécution : entraînement sur la graine 70, réseau semé 68, plafond de 4096 transitions et cinq minutes. Pause et nouvel épisode ne rendent pas du budget à un réseau déjà entraîné.
Évaluer les 3 politiques compare le réseau initial, le réseau actuel en greedy et une baseline uniforme semée 2026 sur les mêmes graines inédites 1000 à 1007, avec au plus 300 actions par épisode. L’évaluation utilise des mondes séparés, ne touche pas à l’arène visible et n’entraîne rien. Les résultats bruts dépliables donnent retour, succès, durée et distance finale pour chaque graine. Un meilleur retour avec zéro cible atteinte reste un échec de navigation, pas une réussite à rebaptiser.
Les tests réels vérifient les collisions et resets, le contrat borné, les fins d’épisode, la modification des poids après entraînement, leur égalité exacte en inférence, la sauvegarde/recharge et le plateau de tenseurs. Les harness navigateur pilotent les vrais boutons et lisent les artefacts IndexedDB. Les preuves datées et liées à leur SHA sont conservées dans evidence/ ; la cadence RAF et son p95 ne sont pas un chronométrage GPU ni une promesse mobile.
pnpm install --frozen-lockfile
pnpm --filter demo-ball-thrust dev --host 127.0.0.1 --port 5173
pnpm --filter demo-ball-thrust test
pnpm --filter demo-ball-thrust typecheck
pnpm test
Ouvrez localhost:5173, ou utilisez directement la démo embarquée. Aucun token, service distant ou modèle préentraîné n’est nécessaire.