· Tutoriel
GridWorld : rendre les décisions d’un agent lisibles
Une grille, quatre actions et une récompense : explorez le Q-learning pas à pas.
Une case de départ. Une cible. Quatre directions possibles. GridWorld permet de suivre une décision d’agent sans devoir interpréter une simulation physique complexe.
Une récompense transforme une promenade sur la grille en problème d’optimisation : arriver compte, mais les détours ont aussi un coût. C’est un terrain lisible pour comprendre comment des expériences changent les valeurs d’action.
Vous allez lancer l’expérience et comprendre le lien entre ses observations, ses décisions et son résultat.
Essayer GridWorld dans le navigateur →
Commencer par la démo
Sélectionnez Q-Table puis Train. Suivez les détours et les épisodes. Passez en Inference pour observer la politique courante. Si vous comparez DQN et Q-Table, recommencez avec un agent neuf pour chaque expérience.
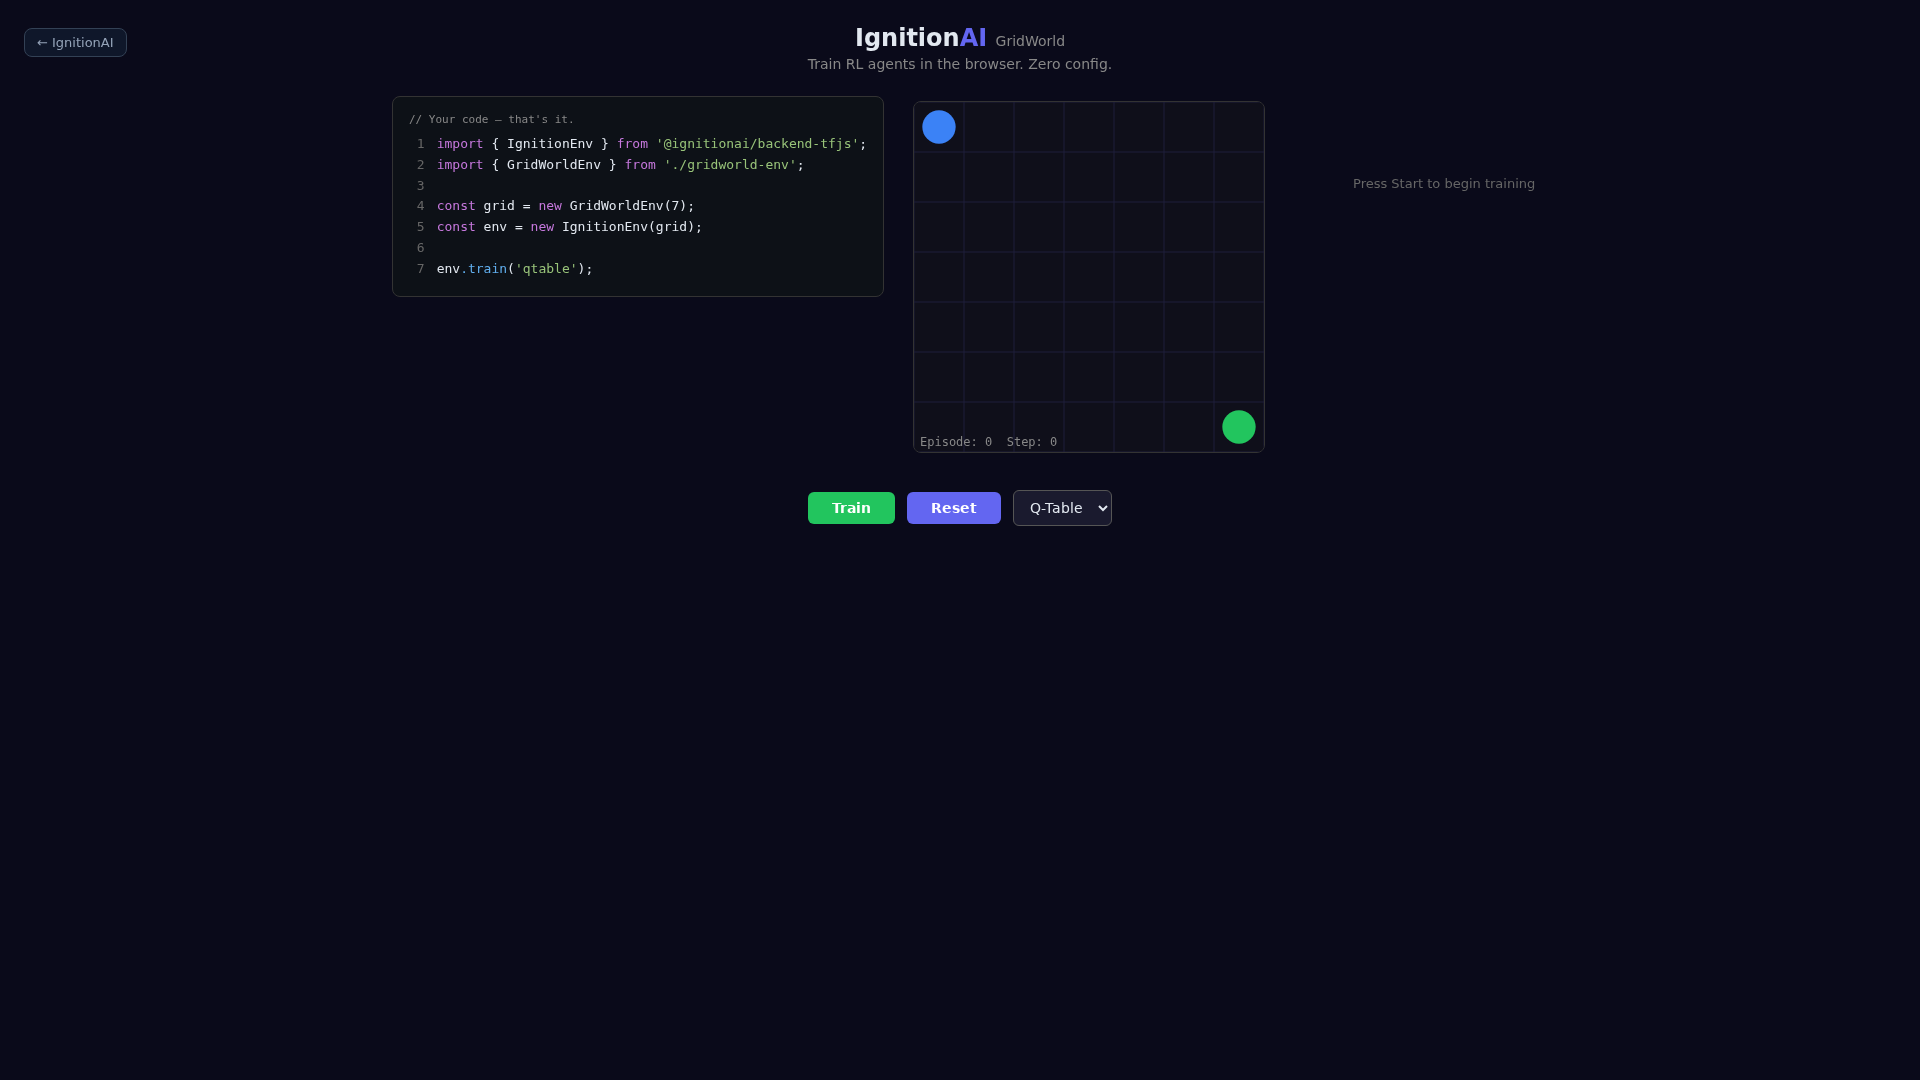
État initial capturé dans Chromium. Les captures servent à montrer le parcours, pas à garantir un score.
Ce que reçoit l’agent
La grille par défaut mesure 7 × 7. L’agent part en haut à gauche et la cible reste en bas à droite. L’observation contient les coordonnées normalisées de l’agent et de la cible. Les actions sont haut, droite, bas et gauche ; une action contre le bord conserve la position.
Ce que la récompense encourage
Chaque déplacement non gagnant rapporte −0,1, et atteindre la cible rapporte +10. L’épisode s’arrête à la cible ou après 100 transitions. Sans obstacle, 12 déplacements suffisent depuis le départ : c’est un repère géométrique, pas un score d’entraînement garanti.
Le contrat complet se trouve dans gridworld-env.ts. Lisez ensemble observe(), step() et reward() : le nom du benchmark ne suffit pas à définir son implémentation.
Comment la table change une décision
Q-Table associe chaque état encodé à une valeur par action. Une transition fournit une cible : la récompense immédiate, plus la meilleure valeur estimée dans l’état suivant si la transition n’est pas terminale. La mise à jour rapproche progressivement la valeur de l’action choisie de cette cible. En inférence, l’agent retient l’action de valeur maximale ; pendant l’entraînement, l’exploration lui permet aussi d’essayer d’autres actions.
Cette estimation explique pourquoi une arrivée récompensée peut finir par influencer des décisions prises plusieurs cases auparavant. Elle dépend cependant des expériences collectées et de la discrétisation utilisée.
Reproduire l’expérience avec du code
Utilisez Node.js 20 ou 22 et pnpm 10.8.0. Depuis le dépôt :
git clone https://github.com/IgnitionAI/ignition.git
cd ignition
corepack enable
pnpm install --frozen-lockfile
pnpm --filter demo-gridworld dev --host 127.0.0.1 --port 5173
Ouvrez localhost:5173. Sur un VPS, utilisez un tunnel SSH vers ce port pour y accéder depuis votre ordinateur.
L’exemple est chargé directement depuis blog-experiment.ts : le code de l’article et celui du dépôt restent synchronisés.
import { IgnitionEnvTFJS } from '@ignitionai/backend-tfjs';
import { GridWorldEnv } from '../gridworld-env';

export function createExperiment() {
  const environment = new GridWorldEnv();
  const runner = new IgnitionEnvTFJS(environment);
  runner.train('qtable');

  return {
    environment,
    runner,
    infer: () => runner.infer(),
    resume: () => runner.train('qtable'),
    stop: () => runner.stop(),
  };
}
Pendant que Vite tourne, vous pouvez importer ce module dans la console du navigateur :
const { createExperiment } = await import('/examples/blog-experiment.ts');
const session = createExperiment();
// Après quelques tentatives :
session.infer();
session.stop();
Le module crée une session indépendante. Il ne la branche pas à la scène déjà ouverte : utilisez les boutons de la démo pour le parcours visuel. infer() applique la politique courante sans entraînement ; resume() conserve l’agent et stop() annule les prochains ticks. Une transition déjà commencée peut encore finir.
Observer, puis évaluer
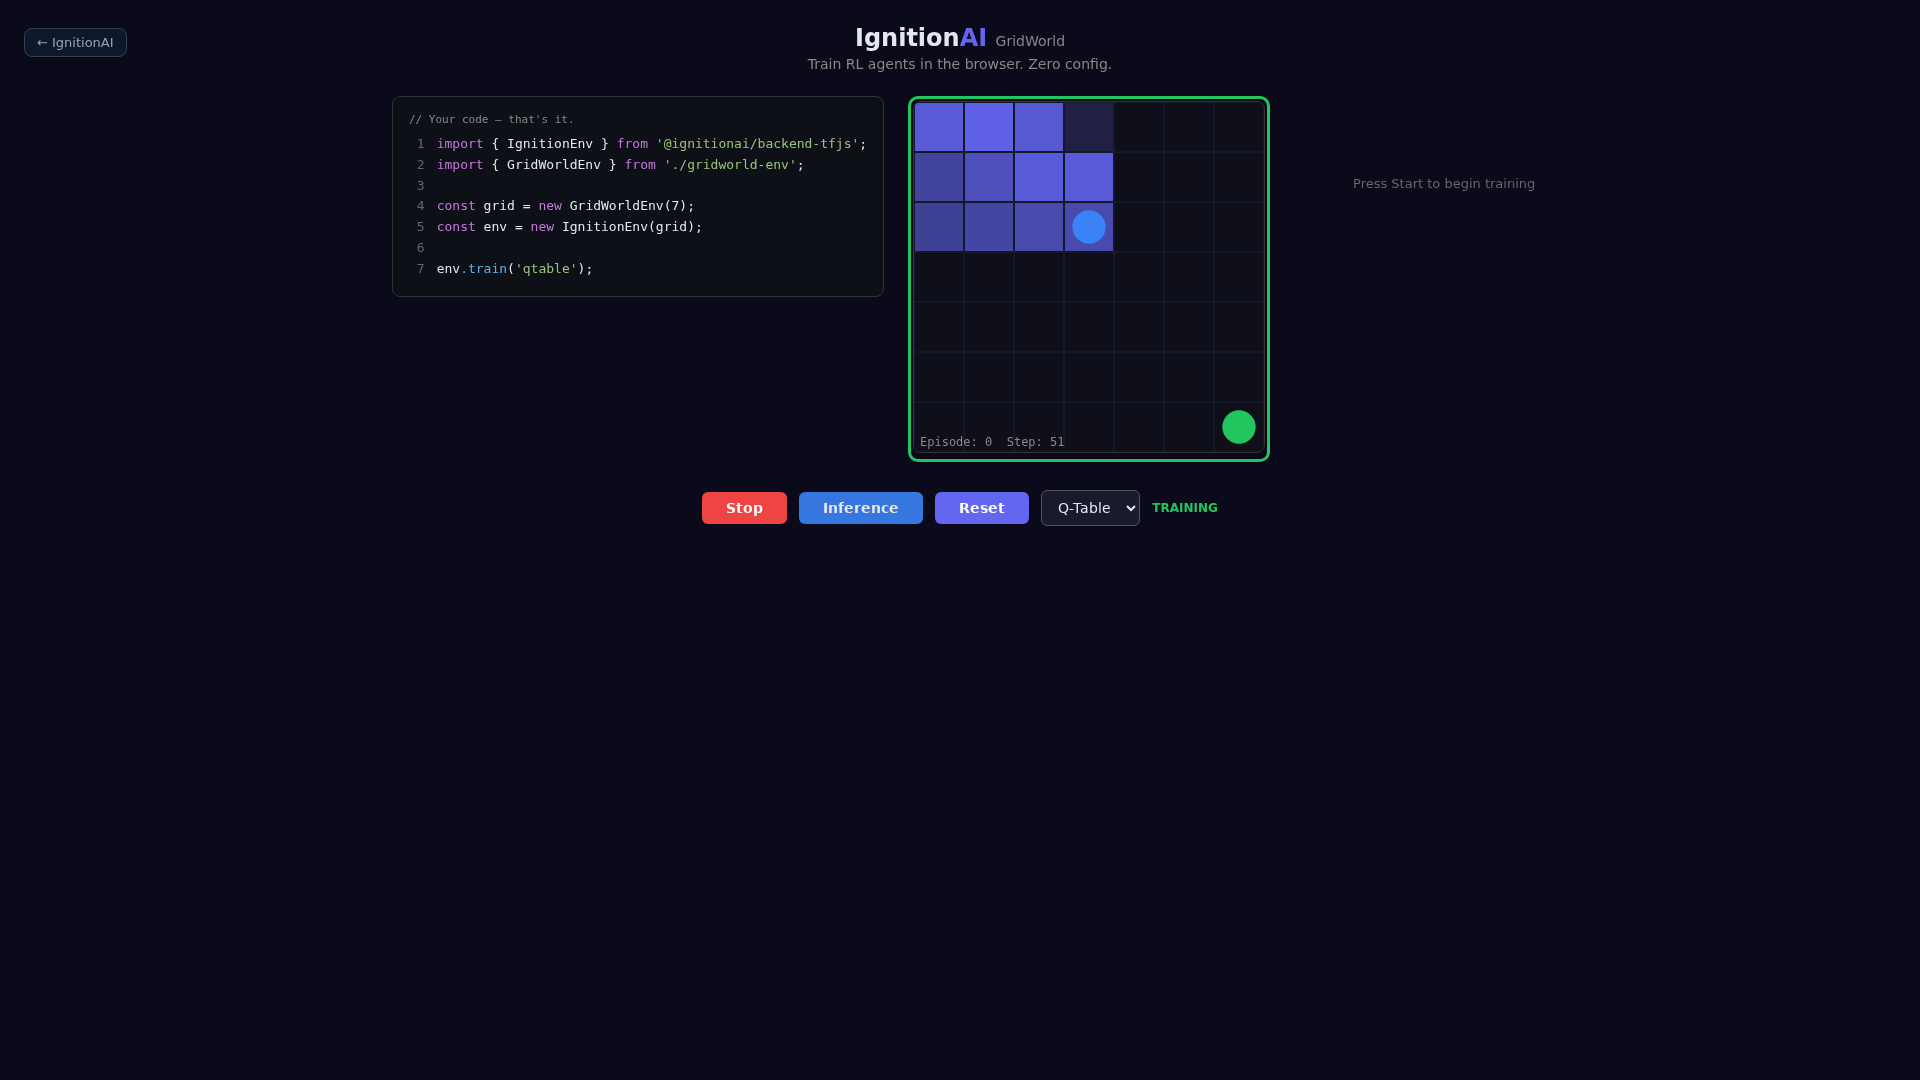
Capture de la même session après interaction. La présence d’une scène et d’un indicateur actif confirme le parcours, pas une politique convergée.
Dans l’exemple, Q-Table discrétise les observations : les coordonnées ne deviennent pas automatiquement des identifiants de cases. Les valeurs par défaut servent à démarrer. Vérifiez les bornes et les bins avant de tirer des conclusions sur la table apprise.
Vérification de cette édition
La démo a été ouverte dans Chromium et son entraînement lancé avant la capture. L’exemple indépendant a exécuté une transition d’entraînement et une transition d’inférence avec 4 observations, puis les commandes de changement de mode. Aucune erreur de page ou de runner n’a été relevée pendant cette vérification. Ce parcours vérifie l’intégration, sans prouver une convergence.
À vous de lancer l’expérience
Reproduisez le parcours, puis modifiez un seul élément du contrat et comparez vos observations. Vous disposerez d’un cas concret pour discuter de ce que l’agent sait, de ce qu’il choisit et de ce que la récompense valorise.
Pour approfondir, consultez le runner Ignition et les algorithmes disponibles.