· Tutoriel
MountainCar : apprendre à prendre de l’élan
Comprendre pourquoi reculer peut aider un agent à atteindre le sommet.
Le sommet est à droite. Pourtant, pousser seulement à droite ne suffit pas toujours. Pour la voiture de MountainCar, une partie du chemin consiste à accumuler de l’élan avant la montée.
Deux observations changent la lecture du trajet : la position et la vitesse. Un déplacement vers la gauche peut être utile si la vitesse acquise prépare le prochain passage vers la droite. La distance au sommet ne raconte donc pas toute l’histoire.
Vous allez lancer l’expérience et comprendre le lien entre ses observations, ses décisions et son résultat.
Essayer MountainCar dans le navigateur →
Commencer par la démo
Choisissez DQN, cliquez sur Train, puis observez les changements de direction. Inference applique ensuite la politique courante sans apprendre. Relevez séparément les arrivées au sommet et les épisodes terminés par la limite.
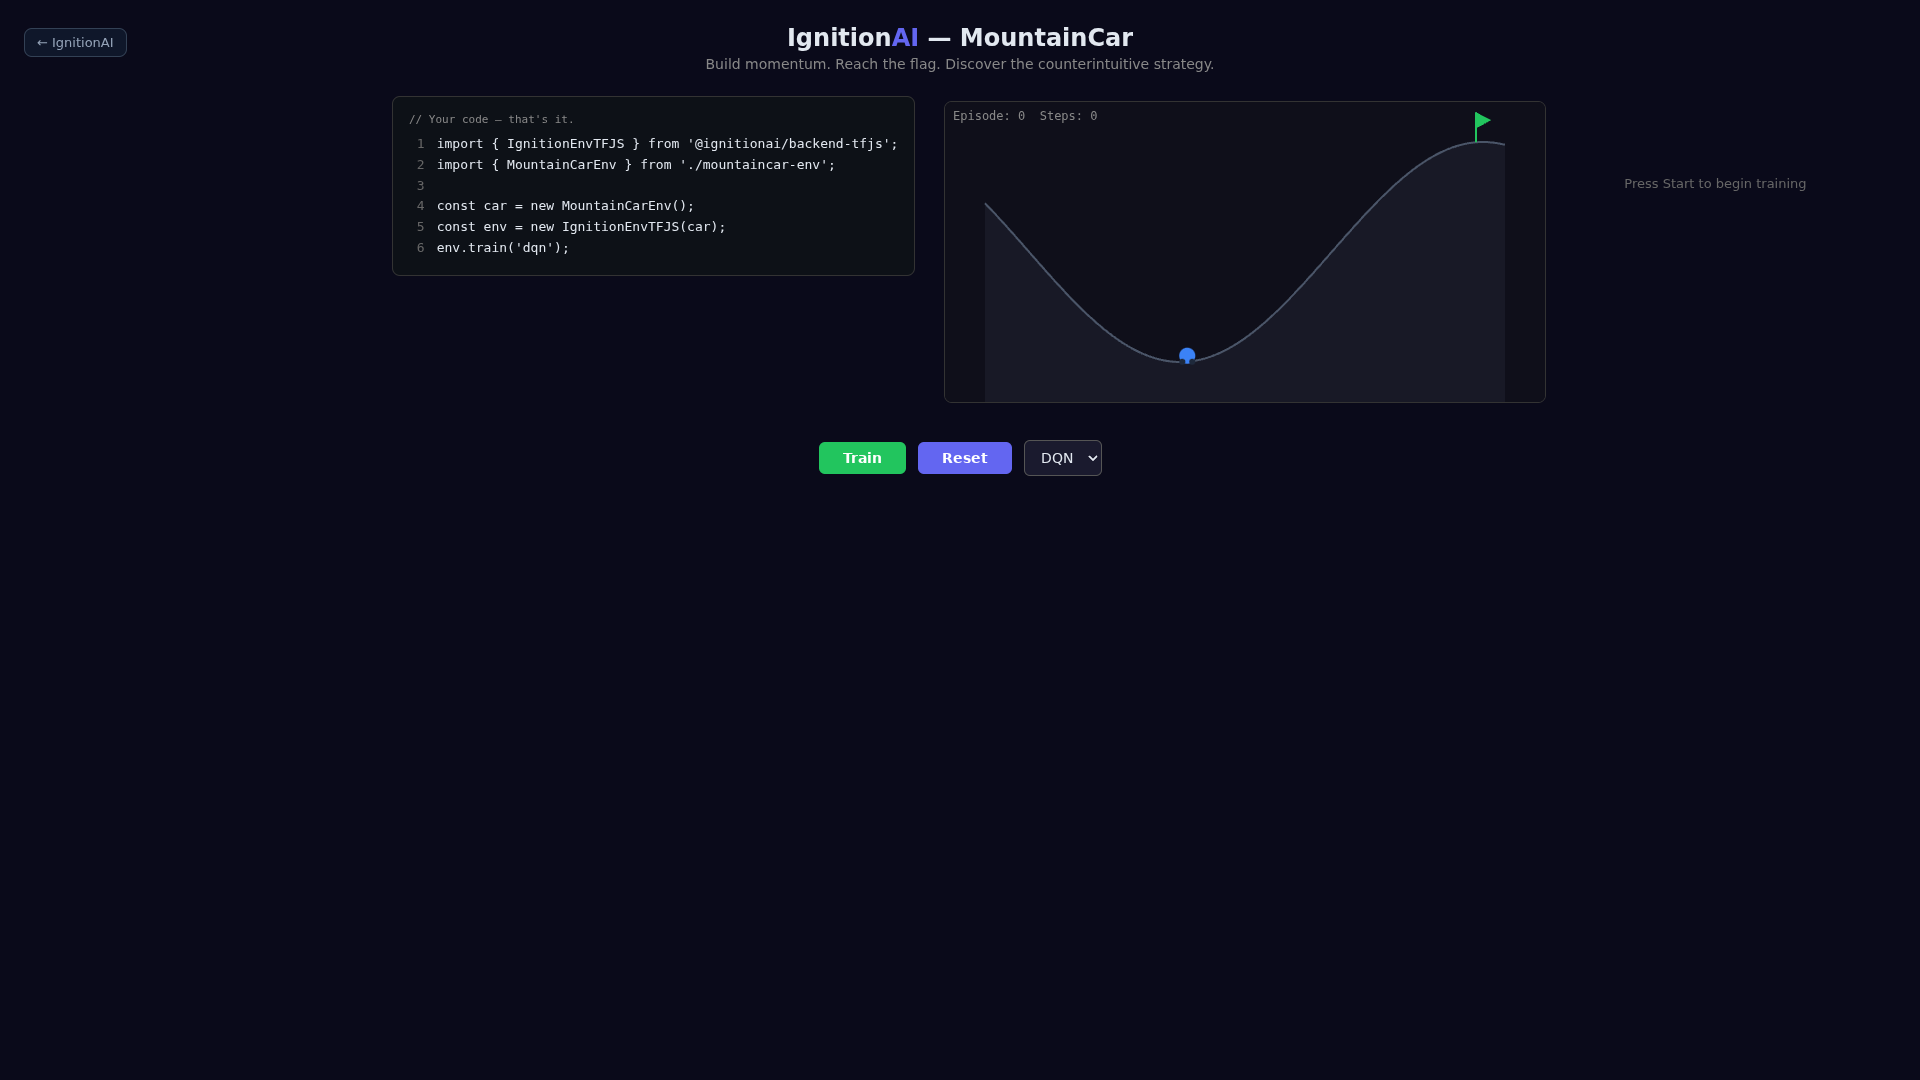
État initial capturé dans Chromium. Les captures servent à montrer le parcours, pas à garantir un score.
Ce que reçoit l’agent
Le modèle reçoit [position, velocity] et choisit pousser à gauche, ne pas pousser ou pousser à droite. La position est bornée entre −1,2 et 0,6 et la vitesse entre −0,07 et 0,07. La force du moteur et le relief déterminent ensemble la transition.
Ce que la récompense encourage
La récompense vaut −1 à chaque transition. L’épisode finit lorsque la position atteint 0,5 ou après 200 transitions. Atteindre vite l’objectif évite des pénalités supplémentaires ; attendre jusqu’à la limite ne constitue pas une réussite.
Le contrat complet se trouve dans mountaincar-env.ts. Lisez ensemble observe(), step() et reward() : le nom du benchmark ne suffit pas à définir son implémentation.
Reproduire l’expérience avec du code
Utilisez Node.js 20 ou 22 et pnpm 10.8.0. Depuis le dépôt :
git clone https://github.com/IgnitionAI/ignition.git
cd ignition
corepack enable
pnpm install --frozen-lockfile
pnpm --filter demo-mountaincar dev --host 127.0.0.1 --port 5173
Ouvrez localhost:5173. Sur un VPS, utilisez un tunnel SSH vers ce port pour y accéder depuis votre ordinateur.
L’exemple est chargé directement depuis blog-experiment.ts : le code de l’article et celui du dépôt restent synchronisés.
import { IgnitionEnvTFJS } from '@ignitionai/backend-tfjs';
import { MountainCarEnv } from '../mountaincar-env';

export function createExperiment() {
  const environment = new MountainCarEnv();
  const runner = new IgnitionEnvTFJS(environment);
  runner.train('dqn');

  return {
    environment,
    runner,
    infer: () => runner.infer(),
    resume: () => runner.train('dqn'),
    stop: () => runner.stop(),
  };
}
Pendant que Vite tourne, vous pouvez importer ce module dans la console du navigateur :
const { createExperiment } = await import('/examples/blog-experiment.ts');
const session = createExperiment();
// Après quelques tentatives :
session.infer();
session.stop();
Le module crée une session indépendante. Il ne la branche pas à la scène déjà ouverte : utilisez les boutons de la démo pour le parcours visuel. infer() applique la politique courante sans entraînement ; resume() conserve l’agent et stop() annule les prochains ticks. Une transition déjà commencée peut encore finir.
Observer, puis évaluer
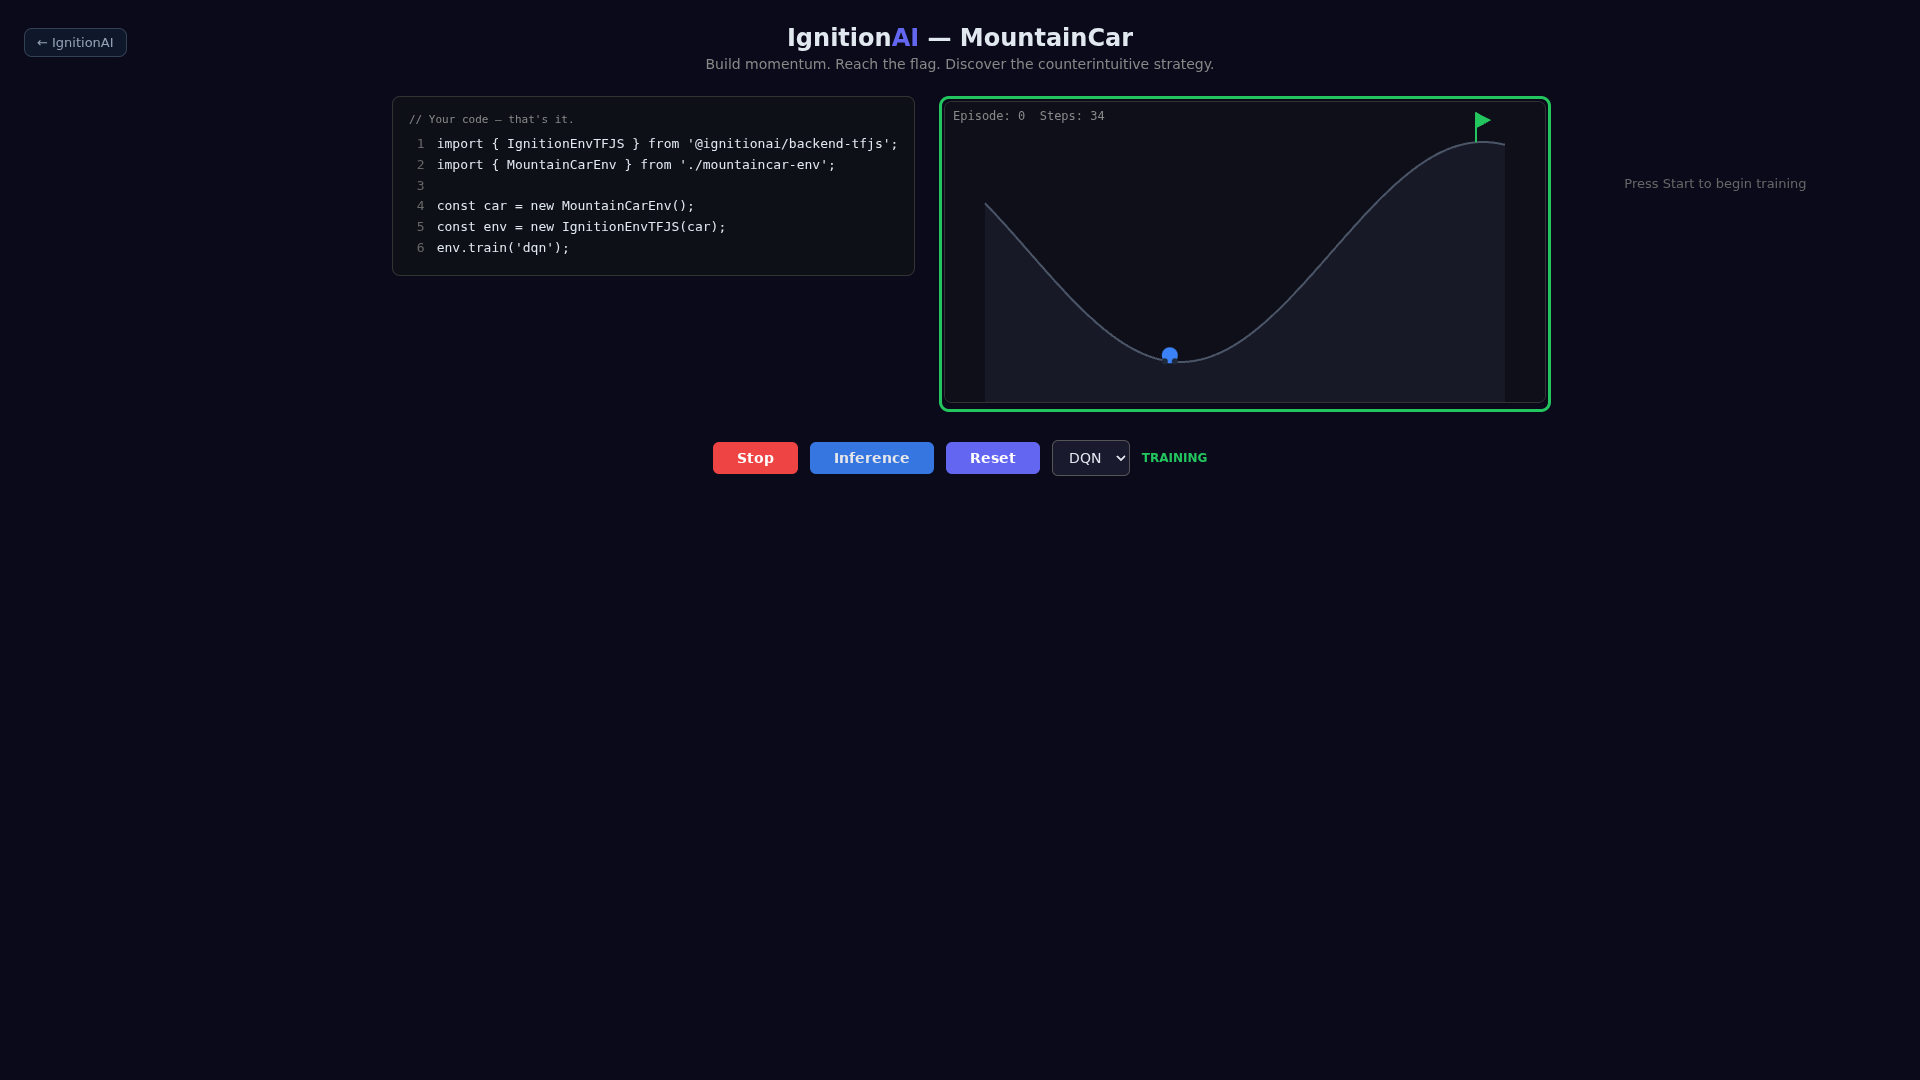
Capture de la même session après interaction. La présence d’une scène et d’un indicateur actif confirme le parcours, pas une politique convergée.
Comparez une stratégie qui pousse toujours à droite avec la politique entraînée, sur plusieurs états initiaux. Notez le taux d’arrivée et le nombre de transitions. Une courbe de récompense seule ne remplace pas ce relevé.
Vérification de cette édition
La démo a été ouverte dans Chromium et son entraînement lancé avant la capture. L’exemple indépendant a exécuté une transition d’entraînement et une transition d’inférence avec 2 observations, puis les commandes de changement de mode. Aucune erreur de page ou de runner n’a été relevée pendant cette vérification. Ce parcours vérifie l’intégration, sans prouver une convergence.
À vous de lancer l’expérience
Reproduisez le parcours, puis modifiez un seul élément du contrat et comparez vos observations. Vous disposerez d’un cas concret pour discuter de ce que l’agent sait, de ce qu’il choisit et de ce que la récompense valorise.
Pour approfondir, consultez le runner Ignition et les algorithmes disponibles.