· Tutoriel
Entraîner son premier agent avec Ignition sur CartPole
Lancez l’expérience dans votre navigateur, puis découvrez le code qui la fait tourner.
Un mât penche. Le chariot pousse à gauche, puis à droite. Le mât tombe. Au prochain épisode, l’agent essaie encore.
Ce petit problème donne quelque chose de concret à l’apprentissage par renforcement : vous voyez les actions, leurs conséquences et la durée de chaque tentative. L’objectif de CartPole est simple à observer : garder le mât debout.
Avec Ignition, vous pouvez lancer cette expérience dans votre navigateur, puis retrouver le code qui la fait tourner. Le framework fournit le DQN et la boucle d’entraînement ; vous pouvez vous concentrer sur les observations, les actions et les résultats.
À la fin de ce tutoriel, vous saurez lancer un entraînement DQN et passer en inférence pour observer la politique courante. Les exemples ont été exécutés et les trois captures proviennent de la même session réelle.
1. Voir l’agent agir
Gardez DQN sélectionné et cliquez sur Train. Le cadre devient vert. Quand un épisode se termine, sa longueur apparaît dans le graphique. Vous pouvez suivre le parcours visuel sans installer le projet.
Pour manipuler le code vous-même, lancez ensuite la démo en local.
Lancer la même expérience sur votre machine
Vous avez besoin de Node.js 20 ou 22, de Git et de pnpm 10.8.0. Nous utilisons le code du dépôt pour que la démo et les exemples correspondent à la même version.
git clone https://github.com/IgnitionAI/ignition.git
cd ignition
corepack enable
pnpm install --frozen-lockfile
pnpm --filter demo-cartpole dev --host 127.0.0.1 --port 5173
Ouvrez http://localhost:5173. Vous retrouvez les mêmes commandes que dans la démo hébergée. Depuis un serveur distant, utilisez un tunnel SSH vers le port 5173 ; l’adresse localhost de votre ordinateur ne désigne pas le VPS.
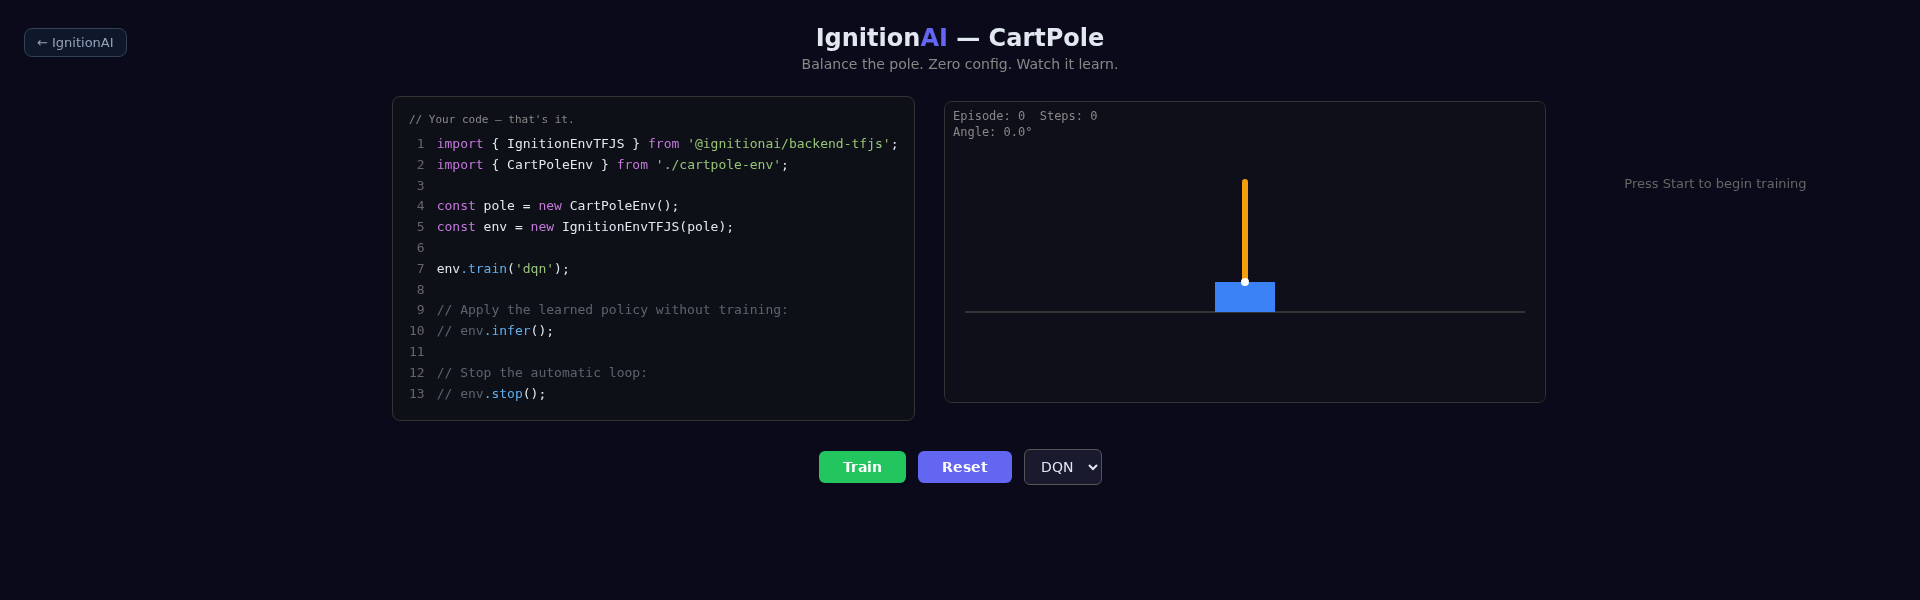
État initial de la démo. Le graphique se remplira à la fin des épisodes.
2. Ce que l’agent doit apprendre
L’environnement fournit quatre nombres : la position du chariot, sa vitesse, l’angle du mât et sa vitesse angulaire. L’agent choisit ensuite l’une des deux actions. Il ne lit pas les pixels du canvas : l’image sert à nous montrer la simulation.
Dans cette implémentation, un épisode se termine lorsque le chariot dépasse ±2,4 mètres, lorsque le mât dépasse ±12 degrés ou après 500 transitions. Chaque transition non terminale rapporte une récompense de 1 ; la transition terminale rapporte 0.
Le graphique intitulé Steps balanced compte les transitions de chaque épisode, y compris la dernière. Il ne représente donc pas exactement la somme des récompenses. Cette différence d’une unité compte lorsqu’on compare des résultats.
3. Le code derrière l’expérience
Voici l’exemple complet, également disponible dans first-agent.ts. L’environnement physique vient du même dossier que la démo.
import { IgnitionEnvTFJS } from '@ignitionai/backend-tfjs';
import { CartPoleEnv } from '../cartpole-env';

export function createCartPoleSession() {
  const pole = new CartPoleEnv();
  const runner = new IgnitionEnvTFJS(pole);

  runner.train('dqn');

  return {
    pole,
    runner,
    infer: () => runner.infer(),
    resume: () => runner.train('dqn'),
    stop: () => runner.stop(),
  };
}
IgnitionEnvTFJS relie l’environnement aux agents TensorFlow.js. train('dqn') crée le DQN et lance la boucle automatique. Le runner déduit les dimensions à partir des observations et des actions ; il fournit également les paramètres par défaut.
L’exemple expose les commandes nécessaires à une interface. session.infer() applique la politique courante sans poursuivre l’apprentissage. session.resume() reprend l’entraînement du même agent. session.stop() annule les prochaines itérations automatiques ; une transition déjà commencée peut encore finir.
Pour essayer ce module pendant que Vite tourne, ouvrez la console du navigateur :
const { createCartPoleSession } = await import('/examples/first-agent.ts');
const session = createCartPoleSession();
// Plus tard :
session.infer();
session.stop();
Ce module crée une session indépendante : il ne la branche pas au canvas de la démo. Pour le parcours visuel, utilisez les boutons de la page. Le fichier App.tsx montre comment synchroniser l’état physique et enregistrer les épisodes dans une interface React.
4. Lire les premières tentatives
Gardez DQN sélectionné et cliquez sur Train. Le cadre devient vert et les épisodes alimentent le graphique. Au départ, l’agent explore. Chaque tentative ajoute une expérience : une observation, une action, une récompense et l’état suivant. Le DQN s’appuie sur ces expériences pour ajuster son estimation de la valeur des actions.
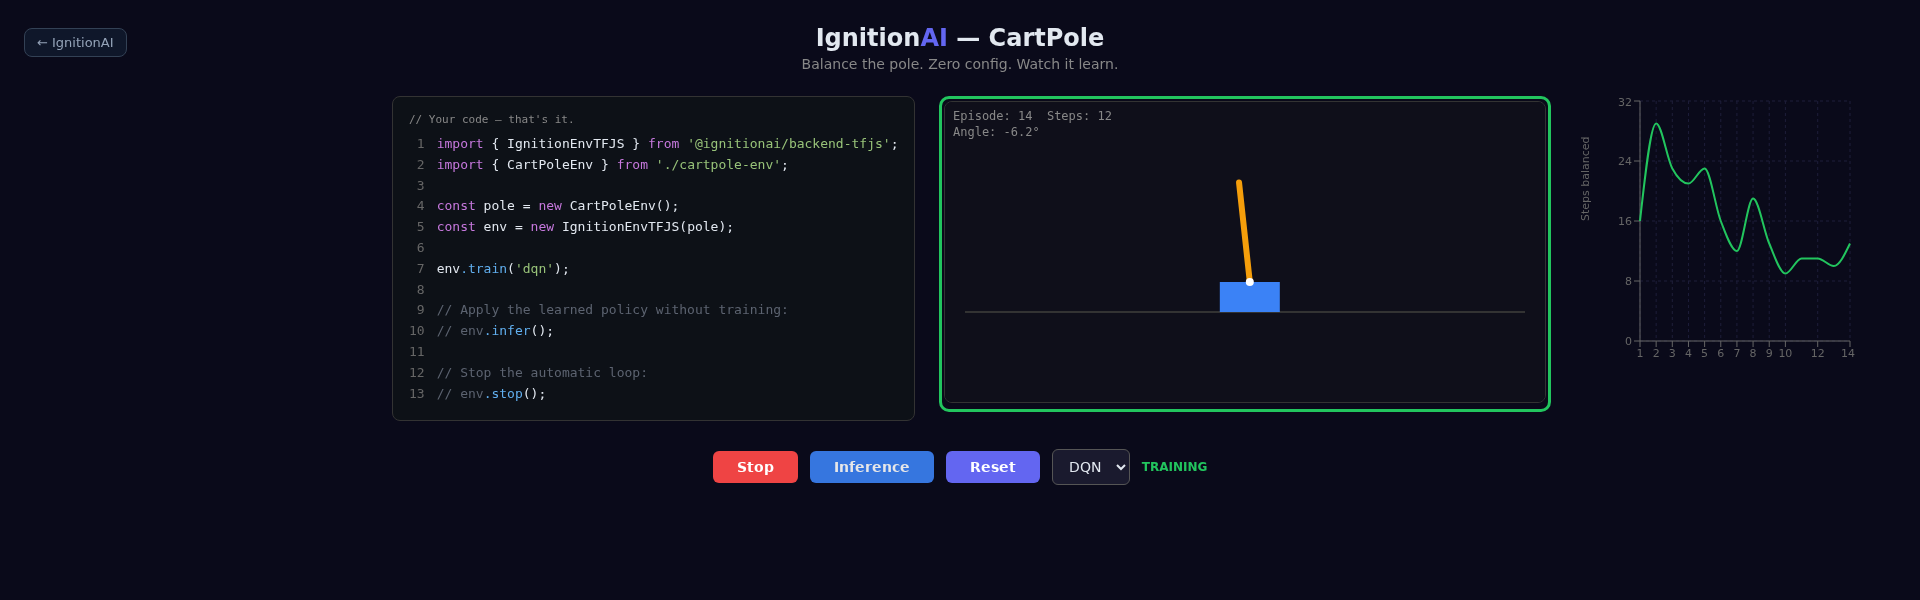
Capture après une minute d’entraînement avec les réglages par défaut.
Ne jugez pas l’agent sur un seul épisode. Comparez plusieurs épisodes successifs et, pour une évaluation sérieuse, plusieurs entraînements indépendants. Les états initiaux, l’exploration et les poids du réseau comportent de l’aléatoire : deux exécutions peuvent produire des trajectoires différentes.
La boucle utilise par défaut un délai de 50 ms entre les ticks, auxquels s’ajoute le temps de calcul. Une minute de temps réel n’équivaut donc pas à un nombre garanti de transitions, ni à une garantie de convergence.
5. Observer ce que l’agent a appris
Pendant l’entraînement, cliquez sur Inference. Le cadre devient bleu. L’agent choisit alors ses actions avec la politique courante, sans mise à jour des poids. Le runner conserve la continuité de la simulation lors de ce changement de mode.
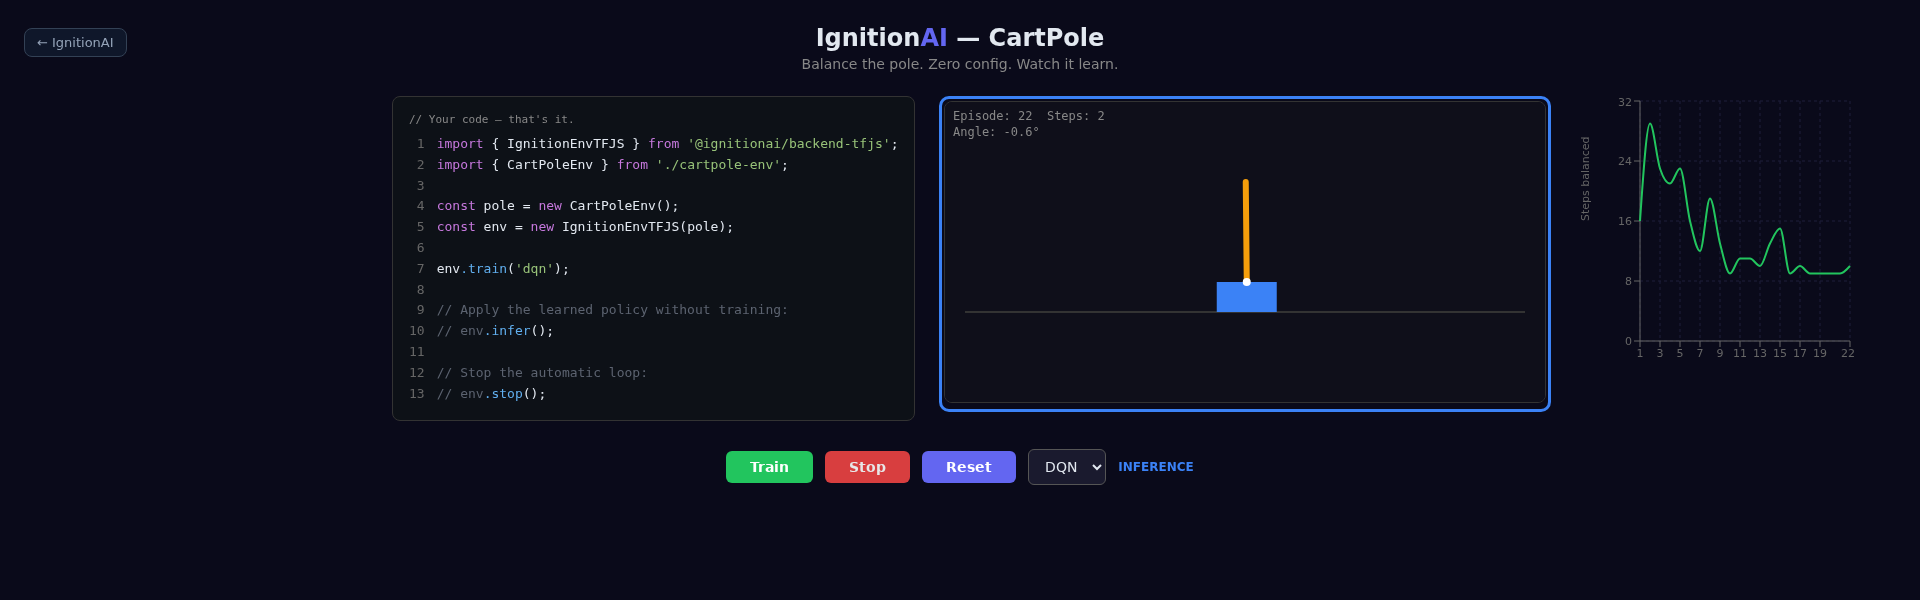
La couleur confirme le changement de mode, pas la qualité de la politique.
La démo continue à enregistrer les longueurs des épisodes en inférence dans le même graphique. Pour mesurer une performance, relevez séparément les épisodes d’évaluation : ne confondez pas les points d’entraînement et les points d’inférence.
Train reprend l’apprentissage ; Stop arrête la boucle. Reset remet la démo à zéro et abandonne l’agent courant. Ne cliquez donc pas sur Reset pour simplement faire une pause.
Un parcours testé, des résultats à évaluer
Pour préparer ces captures, nous avons ouvert la démo locale et lancé DQN pendant une minute : 14 épisodes se sont terminés, avec des longueurs de 9 à 29 transitions. Nous avons ensuite basculé en inférence puis arrêté la session. Les trois images montrent cette même exécution. Nous avons aussi importé le module first-agent.ts dans le navigateur et exécuté une transition d’entraînement, une transition d’inférence et les commandes de changement de mode.
Cette vérification démontre que le parcours et l’exemple fonctionnent. Elle ne démontre pas que CartPole est résolu ou qu’un score donné sera reproduit sur votre machine.
Pour continuer, consultez le fonctionnement du DQN, le rôle du runner et le tutoriel sur les observations CartPole. Vous pouvez ensuite modifier les observations ou comparer les agents, en conservant un protocole d’évaluation identique.
À vous de lancer le premier épisode
Ouvrez CartPole, cliquez sur Train, puis passez en Inference pour observer les décisions de la politique courante. Vous aurez une expérience concrète sur laquelle revenir lorsque vous explorerez le DQN ou modifierez votre environnement.