· Tutoriel
Robot Arm 3D : atteindre une cible XYZ avec un DQN
Un bras idéal à 3 articulations, 325 configurations et 6 actions : suivez comment une récompense dense rapproche l’extrémité de la cible, avec des mesures réelles et leurs limites.
Le bras bouge dans les trois dimensions, mais l’agent ne voit que six nombres. Robot Arm 3D isole une compétence spatiale précise : rapprocher l’extrémité d’un bras cinématique idéal d’une cible XYZ, sans gravité, sans inertie, sans cinématique inverse.
Trois articulations sur une grille de 15° — base, épaule, coude — donnent 325 configurations et une extrémité qui vit dans un volume atteignable en forme de coquille. La 3D n’est pas décorative : les cibles changent de hauteur, de profondeur et de position latérale, et chaque action ne déplace qu’une seule articulation.
Vous allez entraîner un vrai DQN dans le navigateur, puis congeler son réseau pour l’inférence.
Essayer Robot Arm 3D dans le navigateur →
Commencer par la démo
Cliquez sur Entraîner. Le réseau est créé, les poids bougent à chaque mise à jour, epsilon décroît. Passez en Inférence : les poids sont figés, seule la politique gloutonne s’applique. Nouvel épisode tire une nouvelle cible en gardant le réseau ; Recommencer l’apprentissage détruit et recrée le réseau.
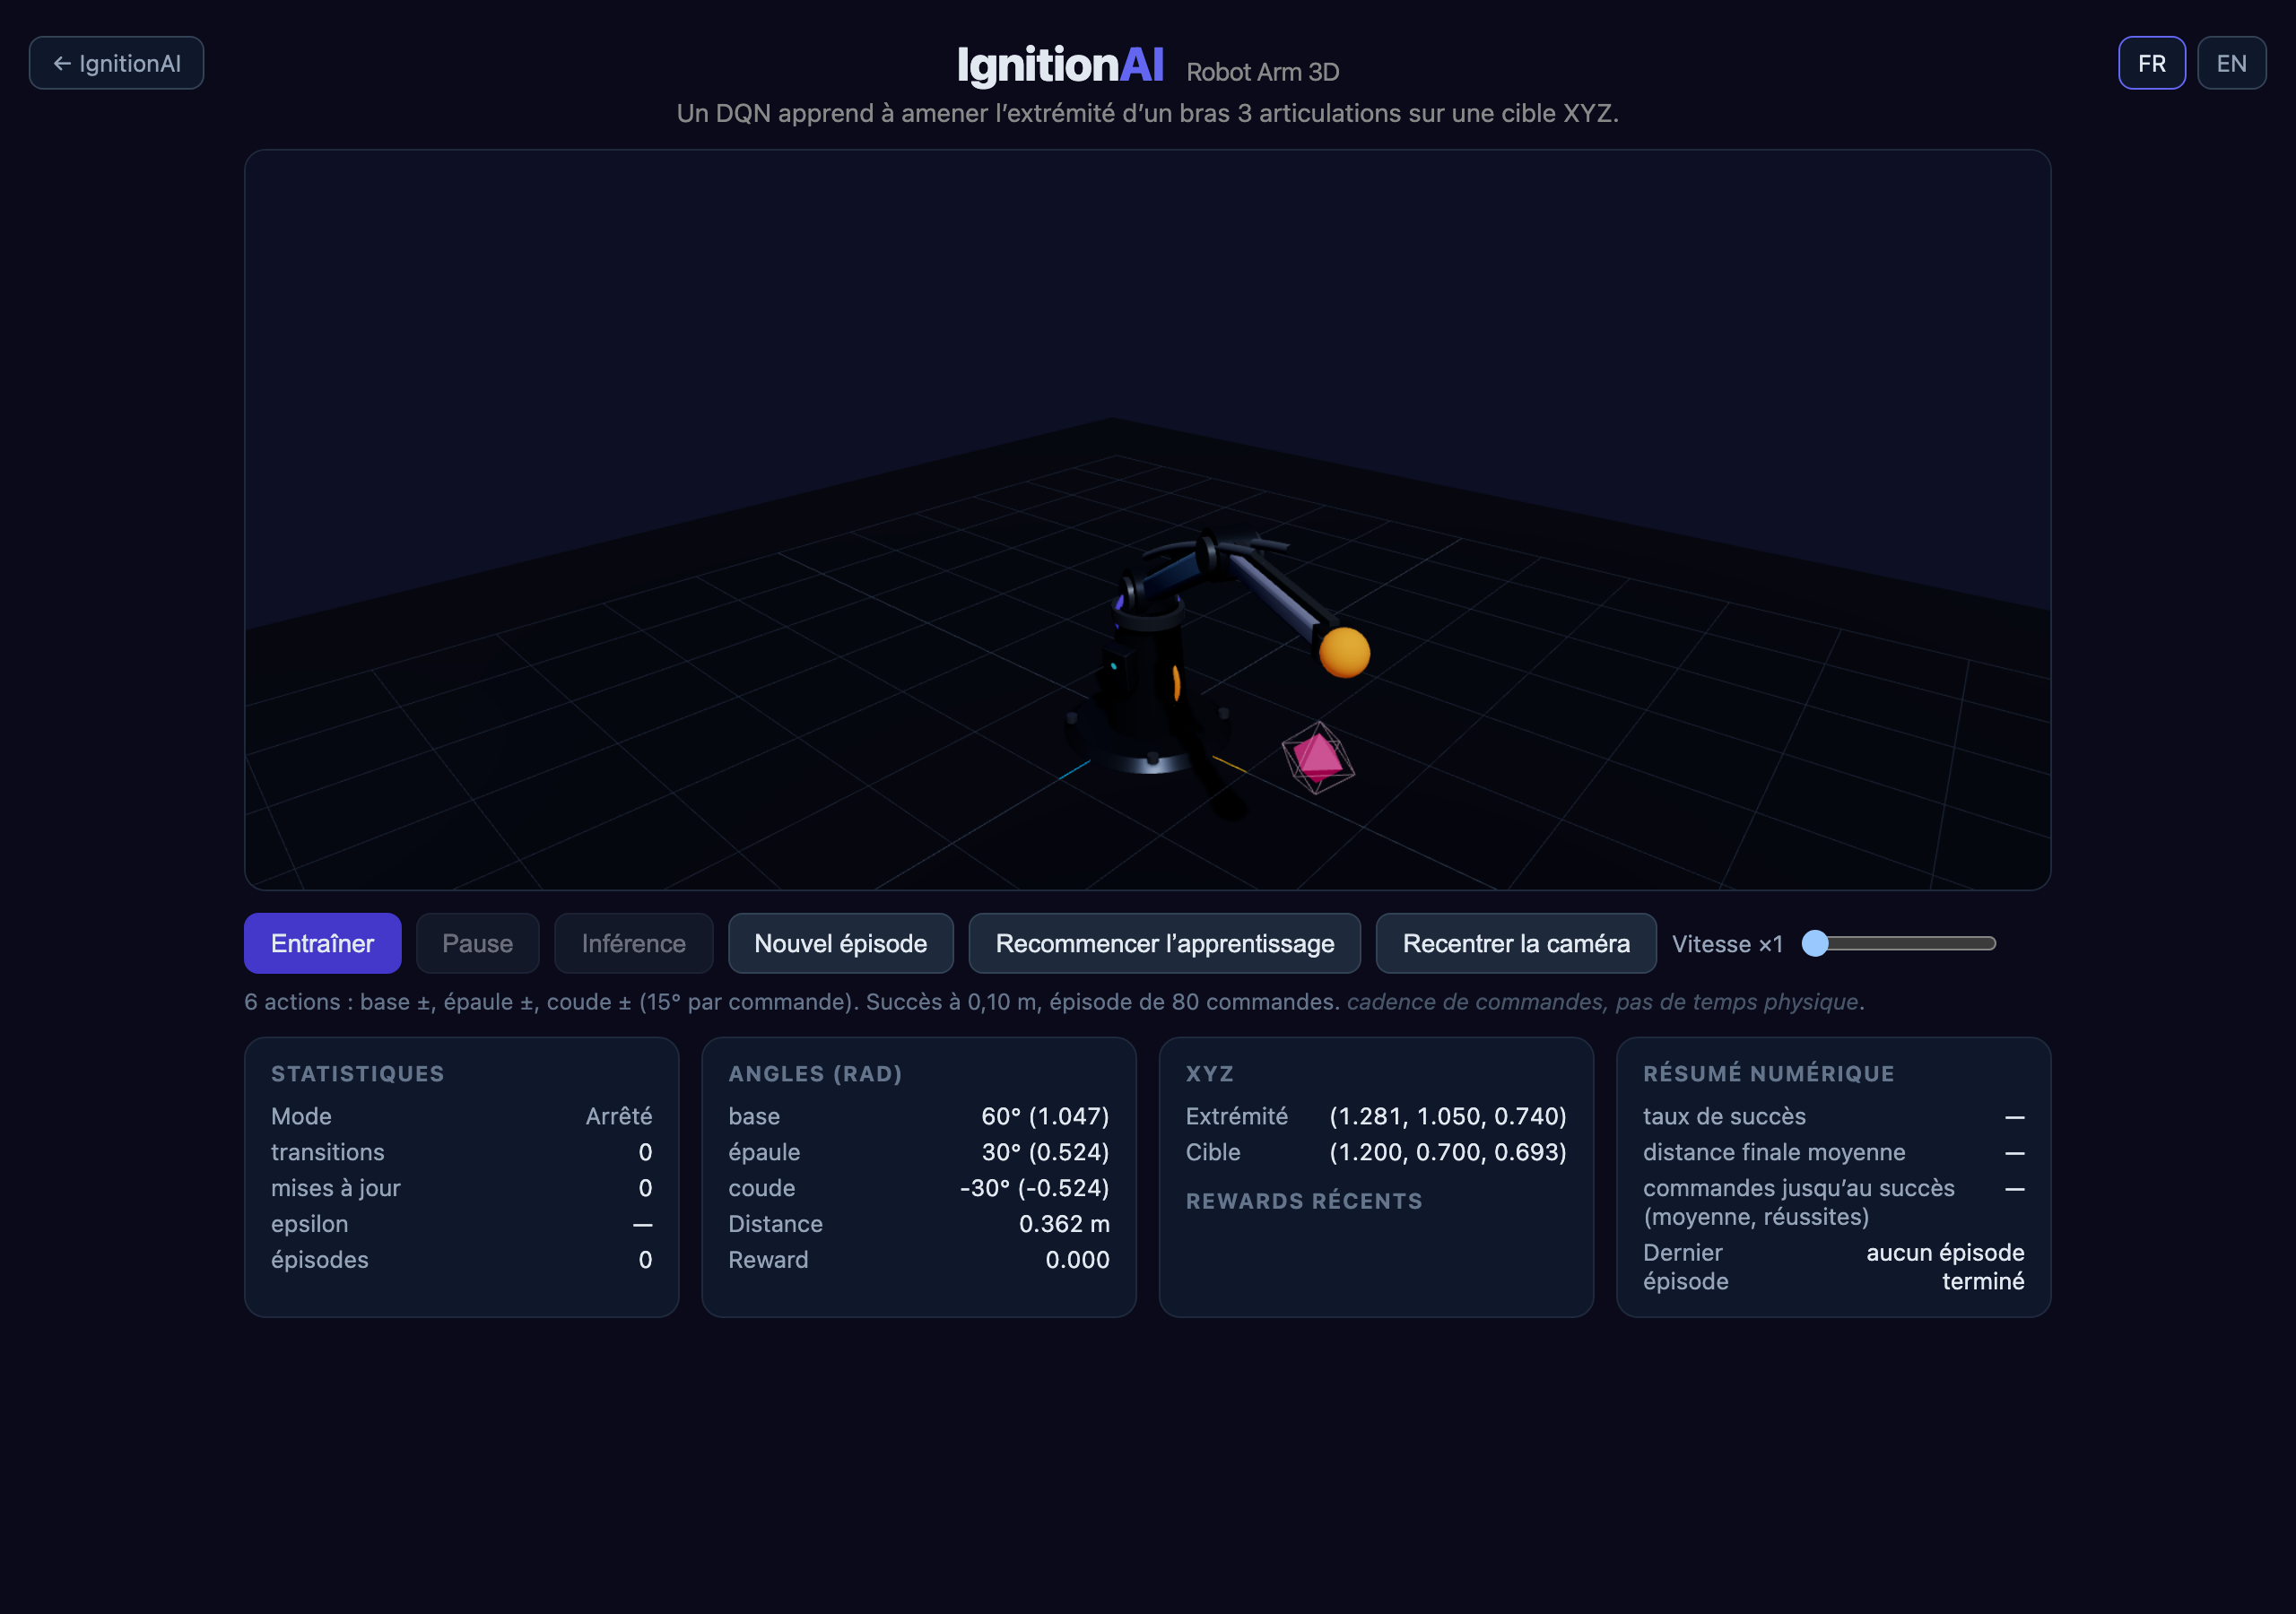
État initial capturé dans Chromium headless. Les captures montrent le parcours, pas une politique convergée.
Ce que reçoit l’agent
Le contrat robot-arm-v1 fixe le pivot à (0, 0,6, 0), L1 = 0,9 m, L2 = 0,7 m. La cinématique directe est exacte : r = L1·cos(q1) + L2·cos(q1+q2), x = r·sin(q0), y = 0,6 + L1·sin(q1) + L2·sin(q1+q2), z = r·cos(q0).
Six observations bornées dans [-1, 1] : les trois angles normalisés, puis (cible - extrémité)/3.2 sur x, y et z. La configuration génératrice de la cible n’est pas exposée — l’agent doit apprendre la géométrie, pas la mémoriser.
Six actions : base ±, épaule ±, coude ±, un pas de 15° par commande. À la limite de la grille, la commande est un no-op comptabilisé comme bloquée. Un épisode dure 80 commandes ; le succès exige d’amener l’extrémité à moins de 0,10 m de la cible — ce qui, sur cette grille, signifie atteindre sa configuration exacte ou l’une des rares configurations voisines (la plus proche paire distincte du grille se situe à ~0,075 m).
Ce que la récompense encourage
Chaque commande reçoit 2(d-d')/1.6 - 0.02d'/1.6 - 0.01 - 0.02·bloquée + succès, où d et d' sont les distances avant/après. Se rapprocher paie, reculer coûte, les commandes bloquées coûtent un peu plus, et le succès ajoute +1. Cette récompense dite dense guide l’agent à chaque commande — contrairement aux tâches à récompense éparsée.
Le réseau est un DQN standard : 6 entrées, deux couches cachées de 64 neurones ReLU, 6 sorties. Taux d’apprentissage 0,001, gamma 0,99, batch 32 sur un replay de 10 000, epsilon de 1,0 à 0,05 avec une décroissance de 0,9995 par mise à jour, réseau cible resynchronisé toutes les 500 mises à jour.
Méthode et mesures réelles
Protocole figé avant l’exécution (robot-arm-v1-protocol-1) : 80 cibles uniques tirées sans remise de la grille (48 entraînement, 12 validation, 20 test), départs d’évaluation déclarés identiques pour toutes les politiques, trois graines 11/29/47 avec flux aléatoires environnement/agent séparés. Budget : 5 000 transitions ou 3 minutes par graine, première limite atteinte — les trois graines ont toutes été arrêtées par le budget de transitions.
Entraînement et inférence utilisent le même contrôleur et le même preset que la démo navigateur ; le backend de mesure est le backend natif TensorFlow (tensorflow, tfjs 4.22.0, macOS arm64). Variation des poids pendant l’entraînement : confirmée (Δ|w| ≈ 419–480, 4 969 mises à jour, epsilon 1,0 → 0,083 sur chaque graine).
| Graine | Réseau initial | Réseau final (greedy) |
|---|---|---|
| 11 | 1/20 succès, d moyenne 1,441 m | 5/20 succès, d moyenne 0,466 m |
| 29 | 0/20 succès, d moyenne 1,805 m | 5/20 succès, d moyenne 0,470 m |
| 47 | 1/20 succès, d moyenne 1,714 m | 11/20 succès, d moyenne 0,283 m |
Politique aléatoire uniforme semée (même épisodes, mêmes départs) : 4/20 succès, distance finale moyenne 1,187 m. En succès, le réseau final atteint la cible en ~6–7 commandes en moyenne contre ~54 pour l’aléatoire. Les 12 épisodes de validation (utilisés uniquement pour observer, sans sélection) vont dans le même sens : 6/12, 9/12 et 7/12 succès.
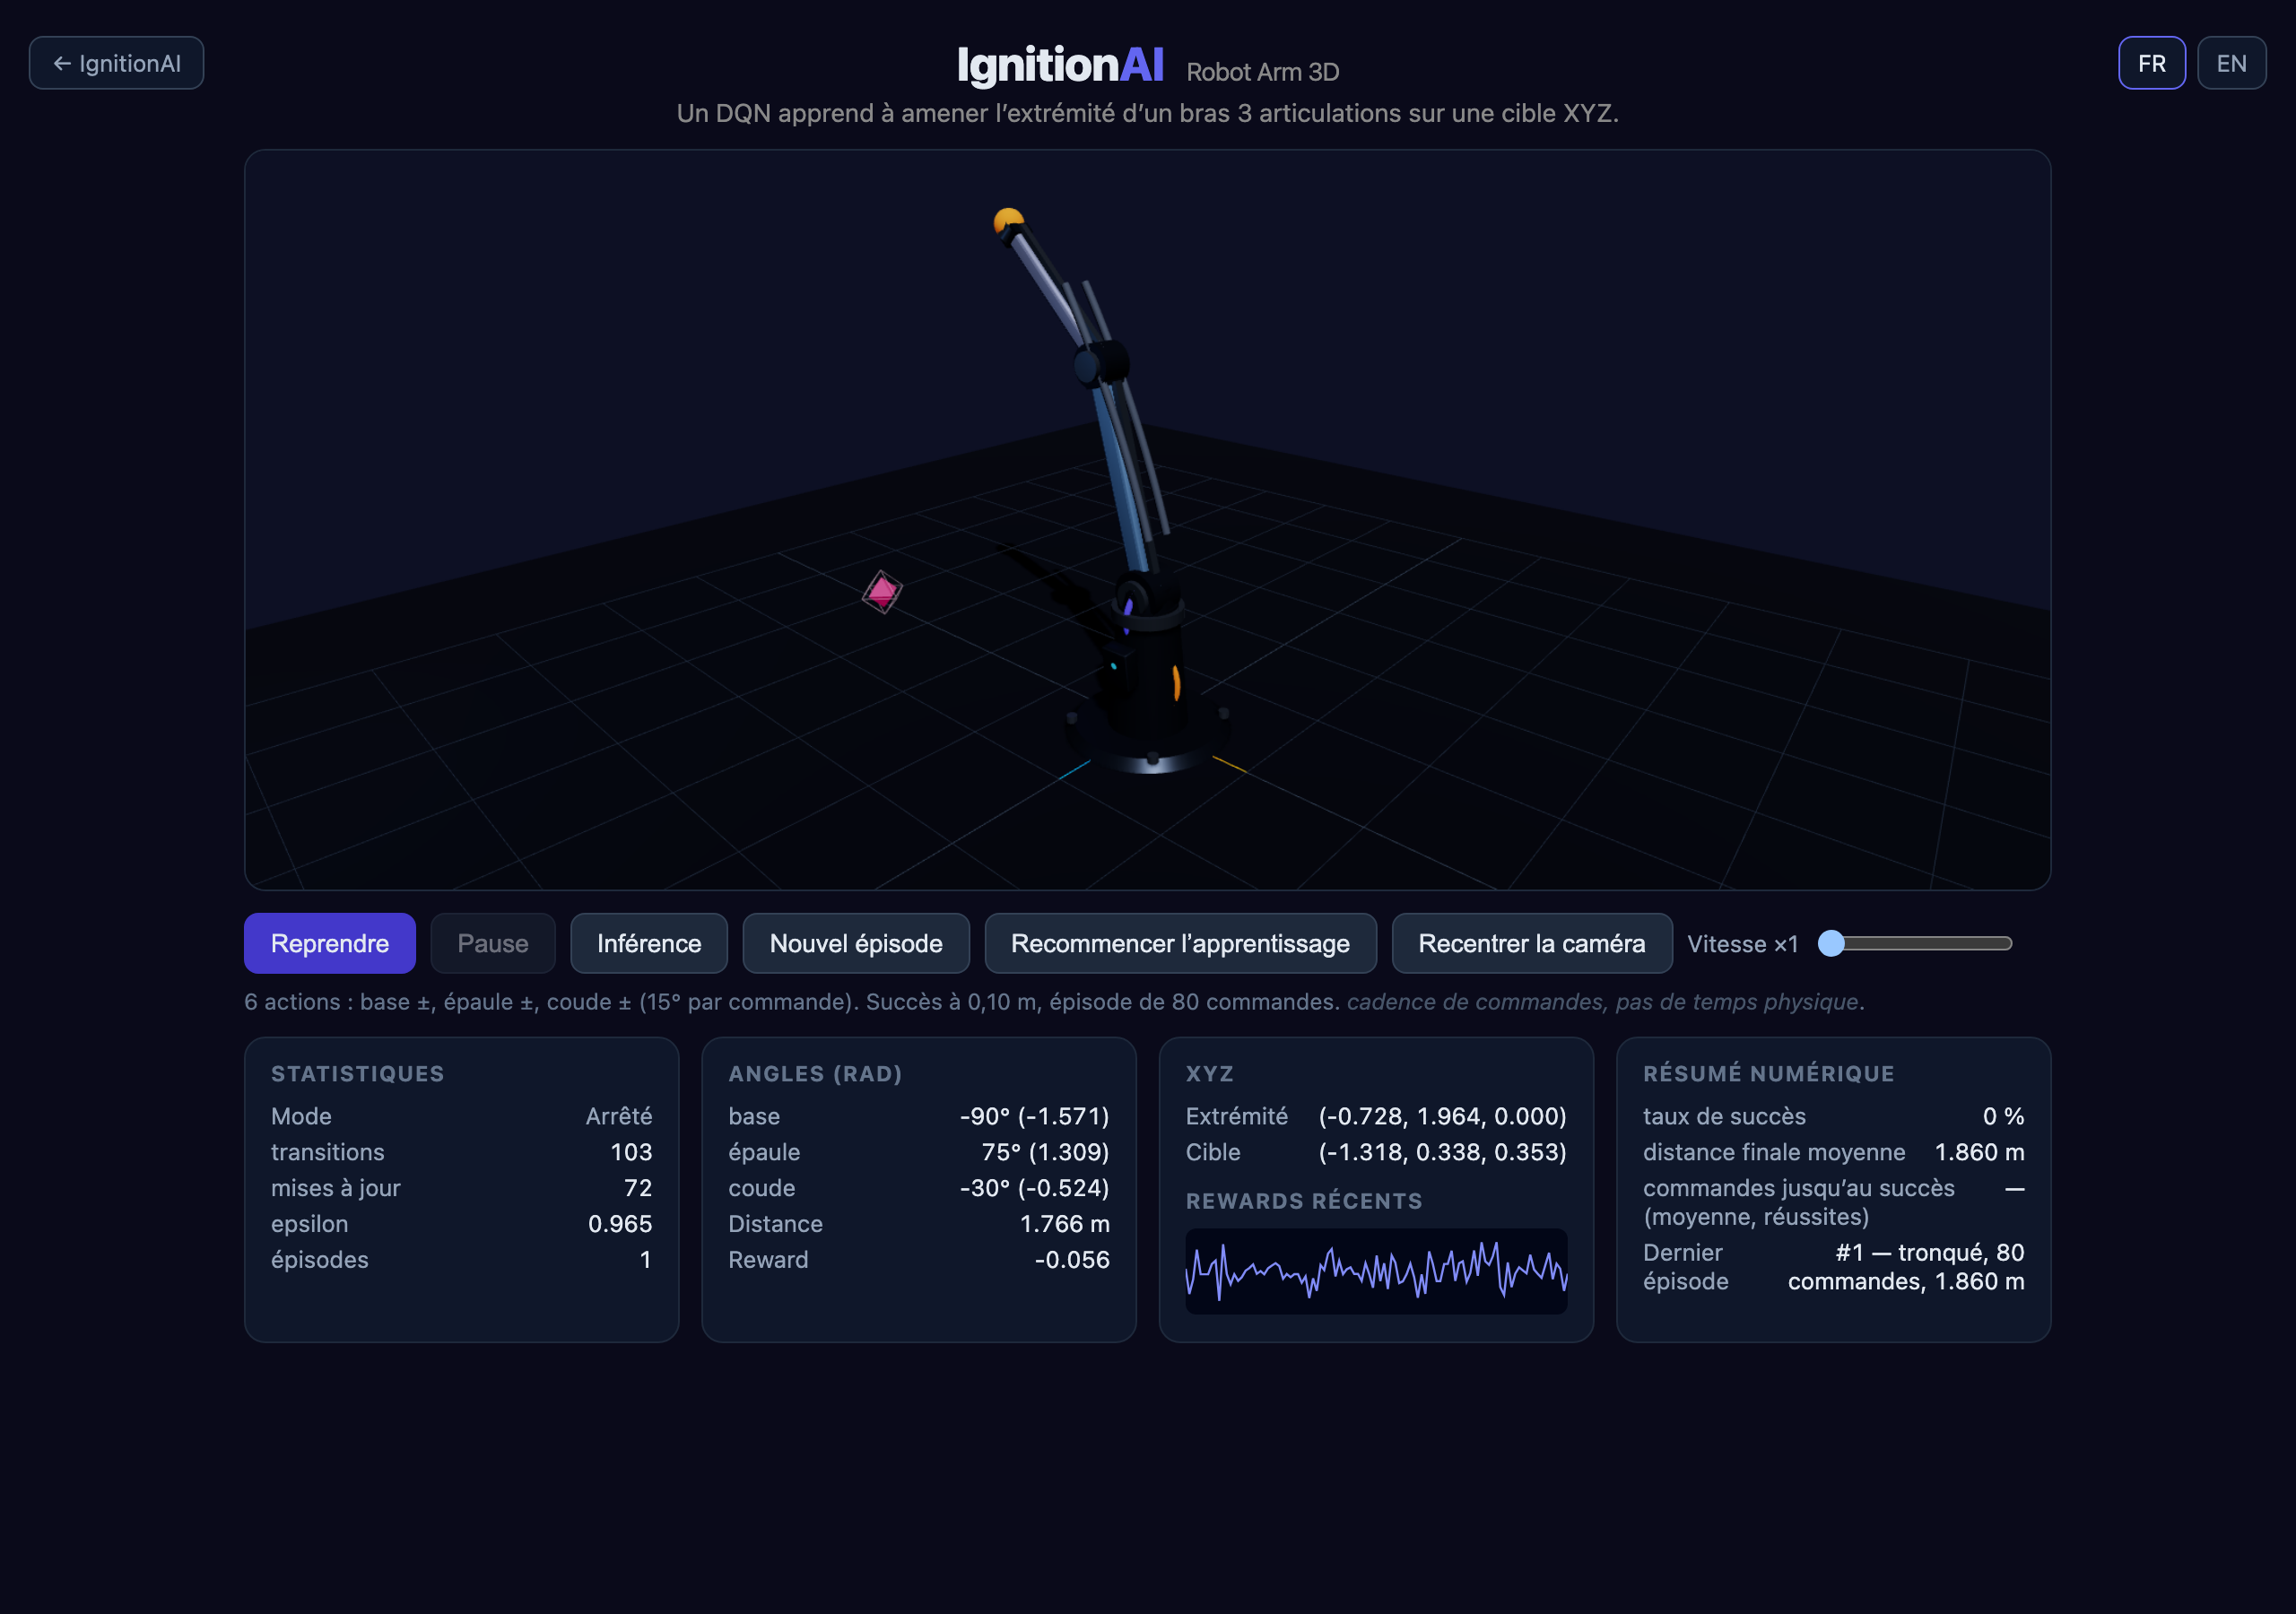
Entraînement réel lancé avant la capture : transitions, mises à jour et epsilon sont les compteurs du contrôleur, pas une simulation.
Ce qu’il faut retenir (et ce qu’il ne faut pas en conclure)
Les trois graines réduisent toutes la distance moyenne d’un facteur 3 à 6 et dépassent la baseline aléatoire. Mais la variation entre graines (5/20 contre 11/20) est réelle, le budget de 5 000 transitions est court, et rien ici ne prouve une convergence : avec ~15 minutes d’entraînement cumulées, le DQN a appris une politique nettement meilleure que le hasard sur une tâche spatiale discrète — c’est la limite honnête du résultat.
L’inférence vérifie l’invariance attendue : poids et compteurs strictement figés pendant les pas gloutons, comme dans la démo.
Reproduire l’expérience avec du code
Utilisez Node.js 20+ et pnpm 10.8.0. Depuis le dépôt :
git clone https://github.com/IgnitionAI/ignition.git
cd ignition
corepack enable
pnpm install --frozen-lockfile
pnpm --filter demo-robot-arm dev
Ouvrez localhost:3011. L’exemple est chargé directement depuis blog-experiment.ts : le code de l’article et celui du dépôt restent synchronisés.
import { RobotArmController } from '../controller';

/**
 * Independent experiment for the blog article — the same controller and DQN
 * preset as the demo UI. Import it in the browser console while `pnpm dev` runs:
 *
 *   const { createExperiment } = await import('/examples/blog-experiment.ts');
 *   const session = createExperiment();
 *   session.train();       // creates the DQN agent, starts training
 *   session.pause();       // stops scheduling, waits for the current transition
 *   session.infer();       // greedy steps with the frozen network
 *   session.stop();        // alias of pause()
 */
export function createExperiment() {
  const controller = new RobotArmController(29);
  return {
    controller,
    snapshot: () => controller.snapshot(),
    train: () => controller.train(),
    infer: () => controller.infer(),
    pause: () => controller.pause(),
    stop: () => controller.pause(),
    newEpisode: () => controller.newEpisode(),
    dispose: () => controller.dispose(),
  };
}
Pendant que Vite tourne, importez le module dans la console du navigateur :
const { createExperiment } = await import('/examples/blog-experiment.ts');
const session = createExperiment();
await session.train();   // crée le DQN, lance l’entraînement
session.pause();         // attend la transition en cours, puis arrête
session.infer();         // politique gloutonne, poids figés
session.stop();
Pour rejouer le protocole de mesure complet (3 graines, évaluation figée, baseline) : pnpm --filter demo-robot-arm measure. Les données brutes par graine sont conservées dans packages/demo-robot-arm/evidence/.
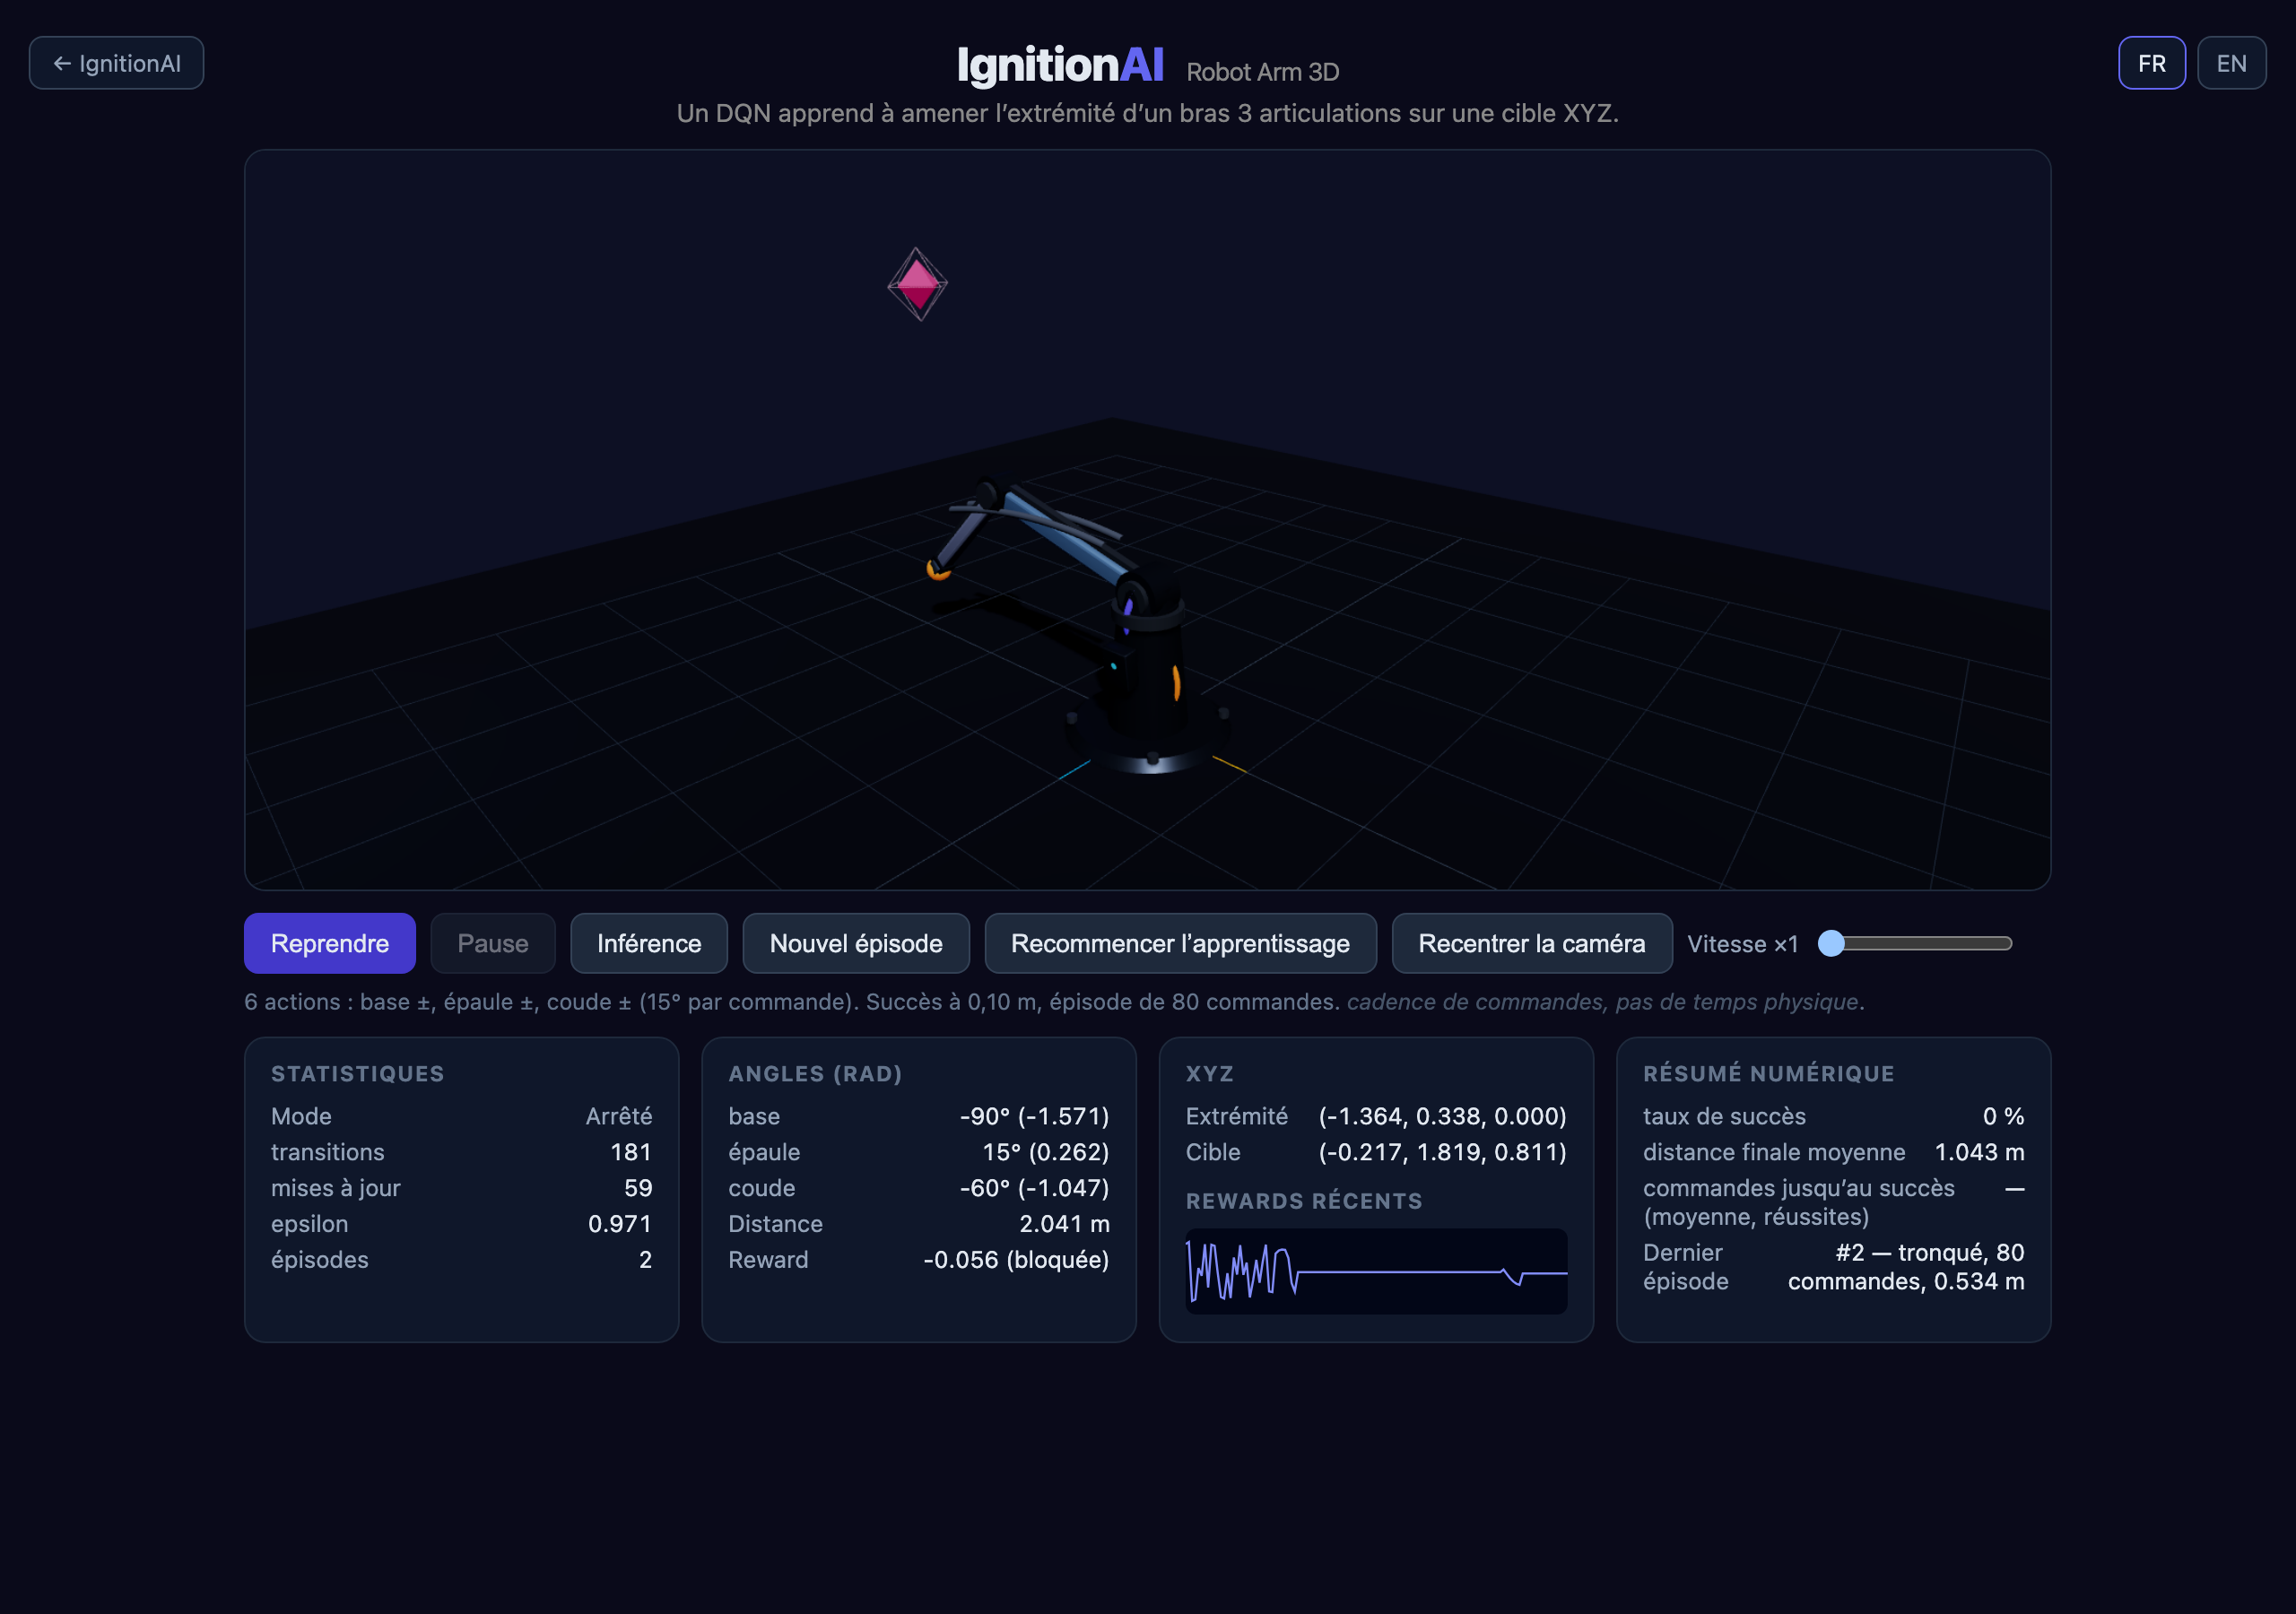
Inférence lancée après l’entraînement, dans la même session. Le mode et les compteurs sont ceux du contrôleur réel.
À vous de lancer l’expérience
Reproduisez le parcours, puis modifiez un seul élément du contrat — la récompense, la grille d’angles, le budget — et comparez. Vous disposerez d’un cas concret pour discuter de ce que l’agent sait, de ce qu’il choisit et de ce que la récompense valorise vraiment.
Pour approfondir, consultez le runner Ignition et les algorithmes disponibles.