· Tutoriel
Circuit Racing : entraîner un pilote, puis mesurer sa course
Prenez le volant et découvrez comment distinguer imitation, DQN et évaluation.
Freiner avant le virage, choisir sa trajectoire et éviter les autres voitures : Circuit Racing donne un terrain visible pour comprendre la différence entre conduire, apprendre et mesurer.
Un pilote peut imiter un contrôleur de référence ou apprendre à partir de récompenses. La course finale doit ensuite utiliser une politique figée. Séparer ces étapes évite de confondre le progrès de l’entraînement avec une performance de course.
Vous allez lancer l’expérience et comprendre le lien entre ses observations, ses décisions et son résultat.
Essayer Circuit Racing dans le navigateur →
Commencer par la démo
Ouvrez le garage, choisissez une voiture et Prendre le volant pour découvrir le circuit au clavier. Passez ensuite à Entraîner : la page distingue entraîner, tester, sauvegarder et courir. L’exemple ci-dessous produit un checkpoint DQN après un petit budget de transitions.
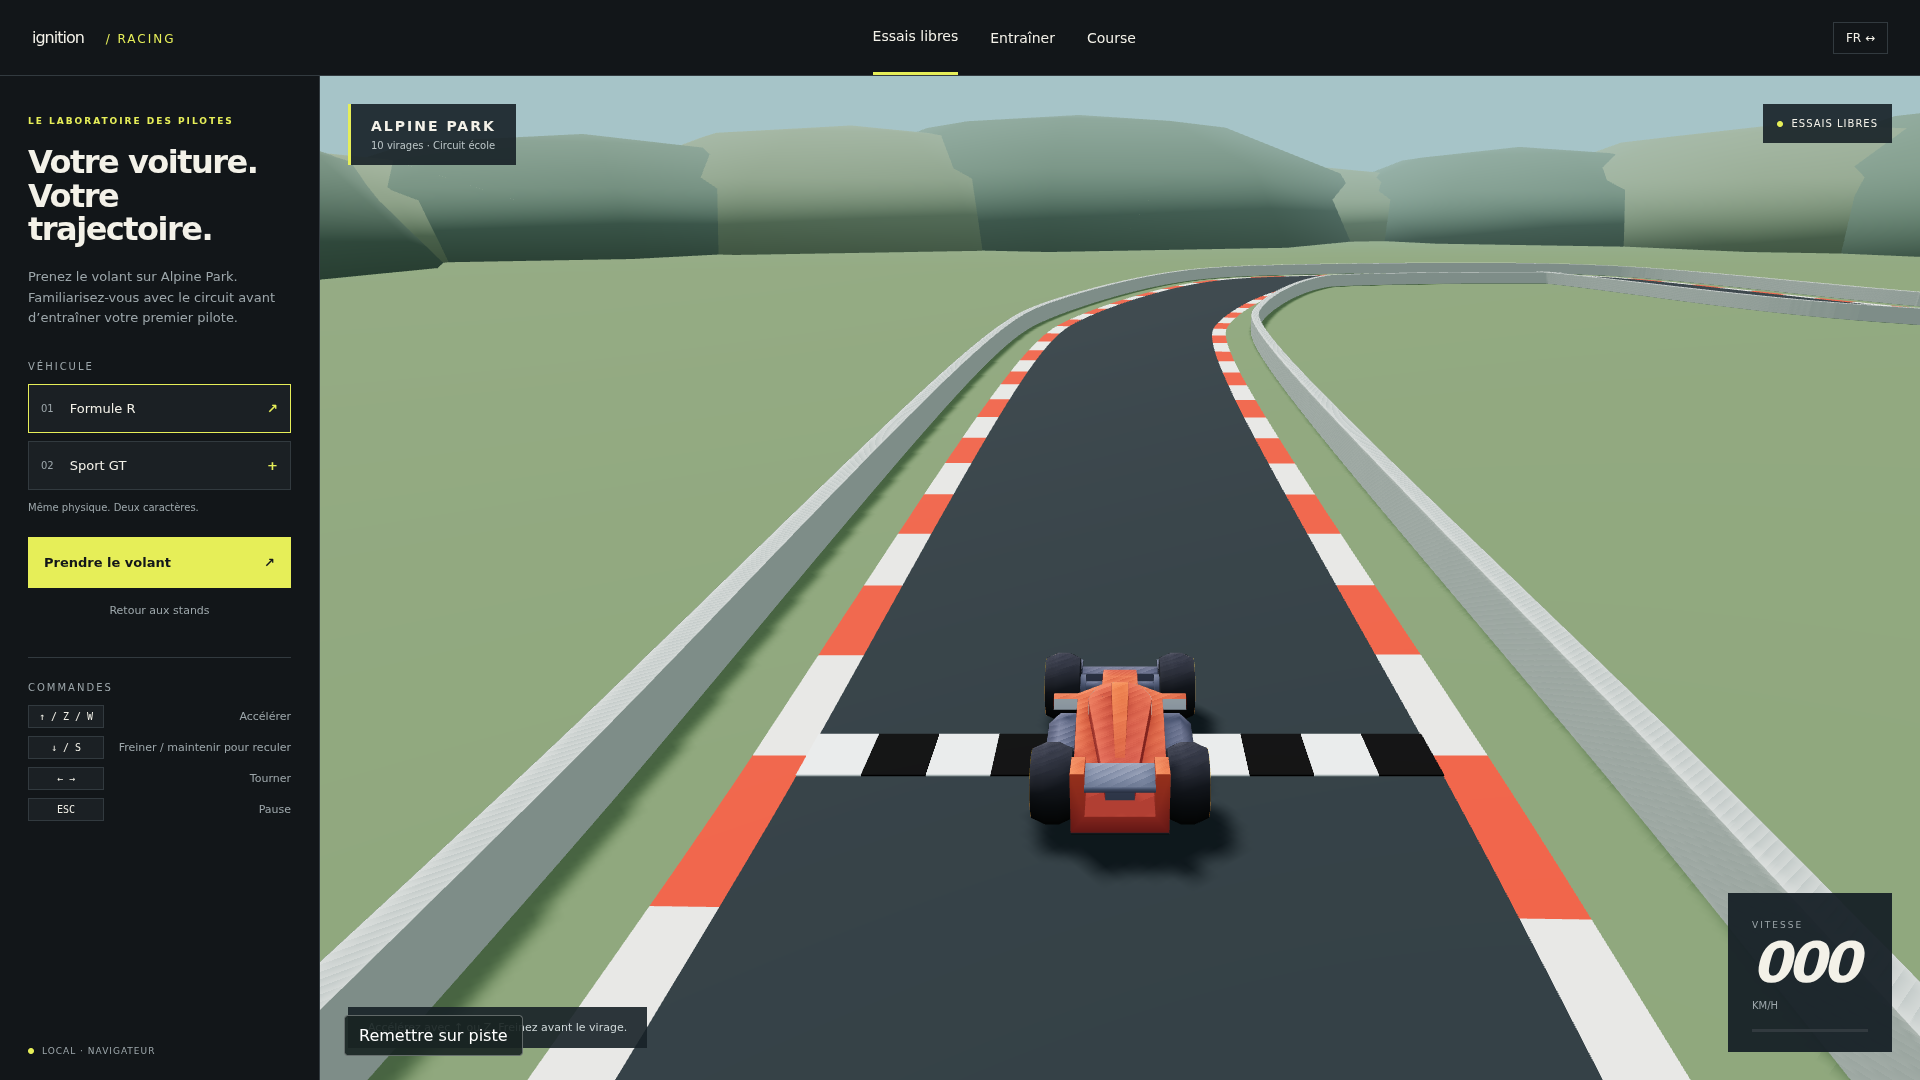
État initial capturé dans Chromium. Les captures servent à montrer le parcours, pas à garantir un score.
Ce que reçoit l’agent
Le contrat racing-observation-v1 contient 20 valeurs : vitesse, direction, décalage latéral, erreur de cap, quatre indications de trajectoire et trois ensembles de quatre valeurs pour les adversaires proches. Le réseau choisit parmi neuf actions. Pour DQN et Double DQN, une décision est maintenue pendant six ticks physiques.
Ce que la récompense encourage
Le Q-learning récompense le progrès sur le circuit et les portes franchies, puis retranche pénalités, coût par décision et sortie de piste. L’imitation MLP apprend au contraire des labels fournis par le contrôleur de référence : sa loss n’est pas une récompense de course. Une comparaison doit nommer le mécanisme utilisé.
Le contrat complet se trouve dans racing/q-training.ts. Lisez ensemble observe(), step() et reward() : le nom du benchmark ne suffit pas à définir son implémentation.
Reproduire l’expérience avec du code
Utilisez Node.js 20 ou 22 et pnpm 10.8.0. Depuis le dépôt :
git clone https://github.com/IgnitionAI/ignition.git
cd ignition
corepack enable
pnpm install --frozen-lockfile
pnpm --filter demo-car-circuit dev --host 127.0.0.1 --port 5173
Ouvrez localhost:5173. Sur un VPS, utilisez un tunnel SSH vers ce port pour y accéder depuis votre ordinateur.
L’exemple est chargé directement depuis blog-experiment.ts : le code de l’article et celui du dépôt restent synchronisés.
import * as tf from '@tensorflow/tfjs';
import { LearnedDriver } from '../racing/learned-driver';
import { trainQDriver } from '../racing/q-training';

export async function trainSmallExperiment(transitions = 64) {
  await tf.setBackend('cpu');
  await tf.ready();
  const driver = new LearnedDriver(11, 'dqn');
  const initial = driver.exportCheckpoint();
  driver.dispose();

  // A smoke run, not the full evaluation protocol.
  return trainQDriver(initial, { transitions });
}
Pendant que Vite tourne, vous pouvez importer ce module dans la console du navigateur :
const { trainSmallExperiment } = await import('/examples/blog-experiment.ts');
const checkpoint = await trainSmallExperiment();
checkpoint.algorithm; // dqn
Le checkpoint est un résultat de ce petit entraînement ; chargez-le dans un LearnedDriver pour appliquer la politique. Ce module utilise le backend CPU exigé par trainQDriver().
Observer, puis évaluer
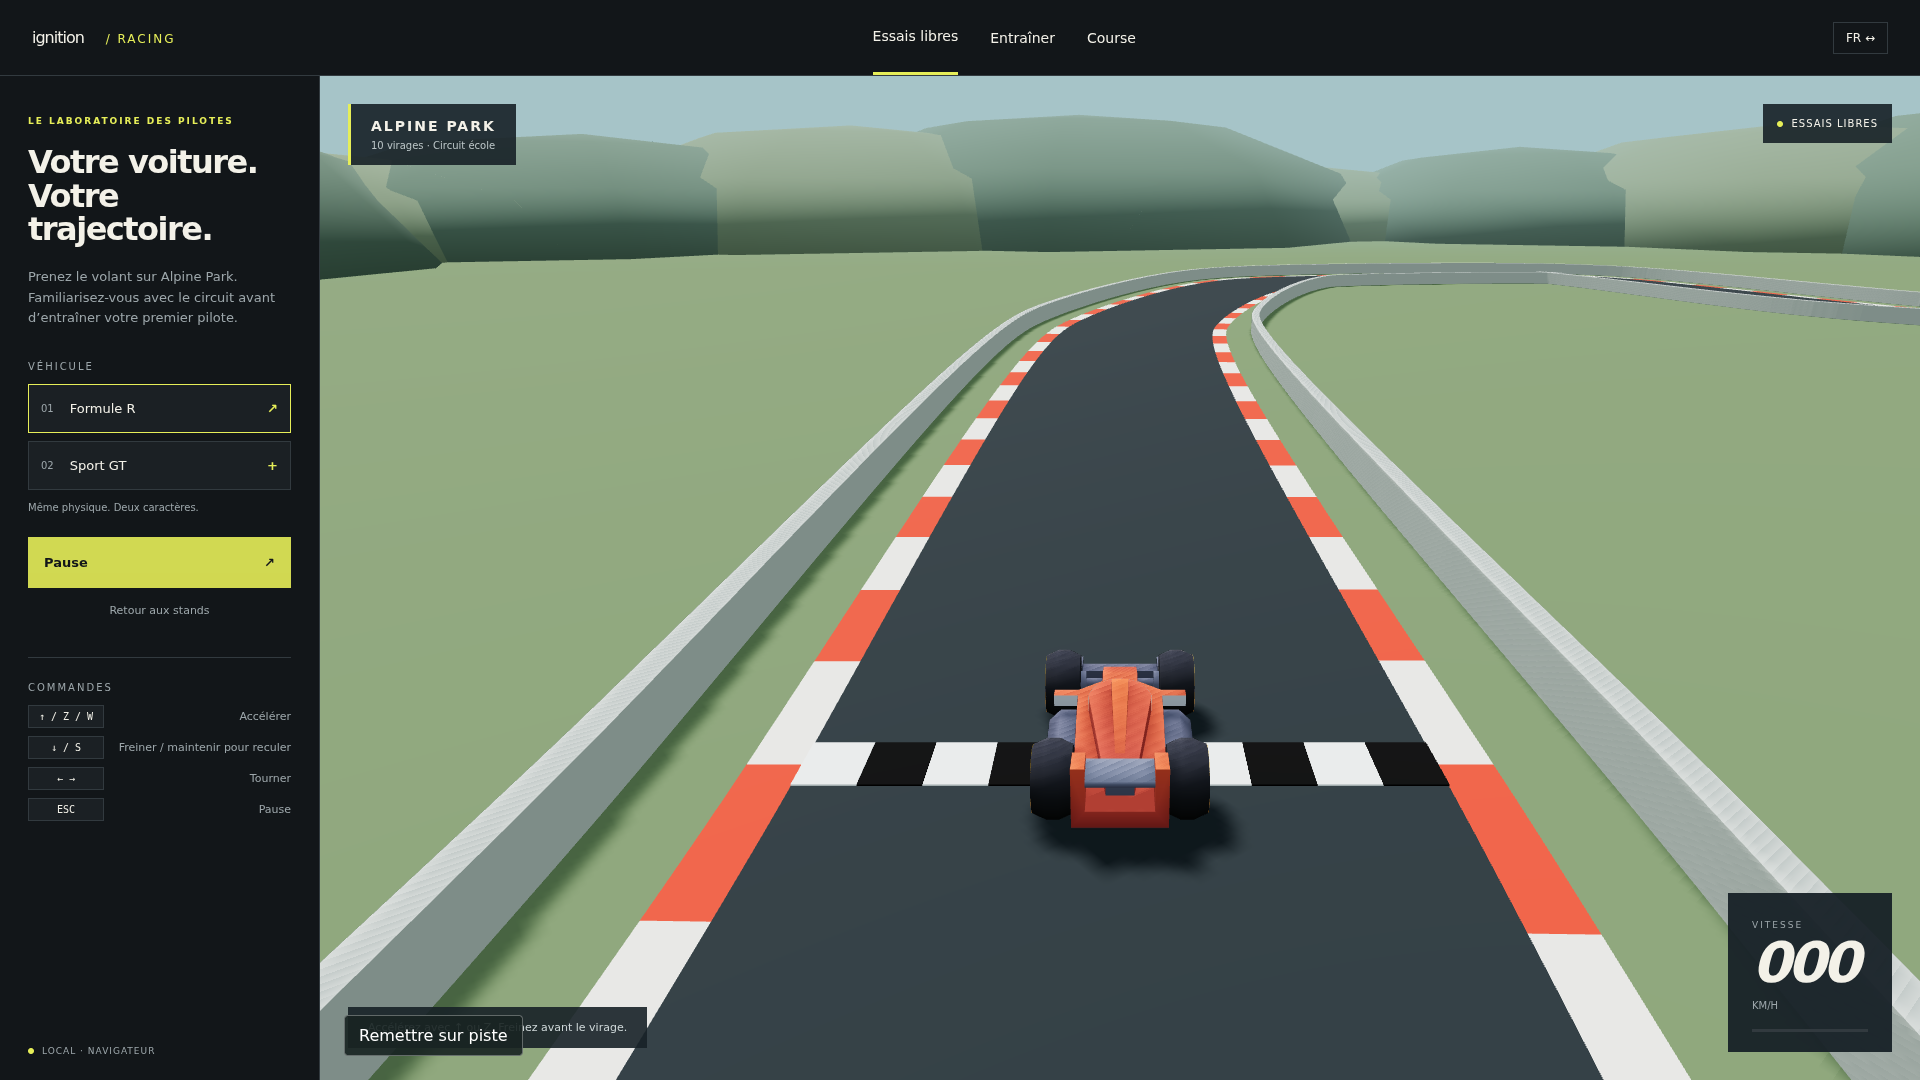
Capture de la même session après interaction. La présence d’une scène et d’un indicateur actif confirme le parcours, pas une politique convergée.
Le protocole Q déclaré utilise 20 000 transitions et une évaluation sur plusieurs graines, deux circuits et les modes solo/trafic. Notre exemple de 64 transitions est une vérification d’exécution, pas ce protocole complet. Lors d’une évaluation, conservez aussi les échecs, sorties de piste et pénalités ; ne sélectionnez pas seulement la plus belle course.
Vérification de cette édition
La démo a été ouverte dans Chromium et les essais libres ont été activés. L’exemple CPU a produit un checkpoint dqn après 64 transitions, avec 9 mises à jour et 6 tenseurs de poids. Aucun résultat de course complète n’est revendiqué.
À vous de lancer l’expérience
Reproduisez le parcours, puis modifiez un seul élément du contrat et comparez vos observations. Vous disposerez d’un cas concret pour discuter de ce que l’agent sait, de ce qu’il choisit et de ce que la récompense valorise.
Pour approfondir, consultez le runner Ignition et les algorithmes disponibles.